第 28 章区块链的后量子迁移
28.1本章为何重要#
区块链是现存最困难的后量子迁移问题之一,原因有二,而上一章对此仅略有涉及。第一,资金由签名保护,而其公钥迟早会在不可篡改的账本上永久公开——于是“先存储、后解密”演变为更为尖锐的“先存储、后盗取”。第二,区块链没有管理员:修改 Bitcoin 或 Ethereum 的规则是一个治理问题,需要通过粗略共识和分叉来解决,而不是向服务器推送一次软件更新。本章考察三个生态系统截至 2026 年年中实际上如何推进这一过渡:规模最大的两个——Bitcoin 和 Ethereum,以及在已发布代码方面走得最远的 Cosmos。这里的一切都在变化之中:具体提案都是草案,而非已部署的共识规则,读者应将其中的日期和状态视为一个快照。
Mosca 不等式 \(x + y > z\)(第 1 章)用一行式子刻画了这个问题,而区块链正是它退化的情形。链上已暴露公钥的保密期 \(x\) 不是以年计的:账本不可篡改且公开,因此只要链存在、币未被移动,该密钥就一直是攻击目标。\(x\) 无界时,\(x + y > z\) 对任意迁移时间 \(y\) 和任意有限的 \(z\) 都成立。因此,这个不等式无法通过更好的硬件预测或更快的行动来满足;唯一的出路是消除暴露——而这意味着移动币。正因如此,本章中的每一份路线图,无论在其他方面存在何种分歧,最终都在争论如何促使用户采取行动。
28.2学习目标#
读完本章后,你应当能够:
解释量子计算机会攻破(Shor)哪些区块链原语、仅会削弱(Grover)哪些原语,以及公钥暴露原则;
按输出类型描述 Bitcoin 的暴露情况和当前的草案提案(BIP-360、BIP-361),并区分由协议设计造成的暴露与由用户行为造成的暴露;
按谁能修复对二层网络(layer 2)的密码学攻击面进行清点;
解释为何基于哈希的层或对称层并不能使系统成为后量子安全的,以及应当转而追问什么;
描述 Ethereum 的暴露情况及其双线计划:紧急硬分叉和基于账户抽象的迁移;
解释为何 EdDSA 链允许一条 ECDSA 链所不具备的迁移路径,以及为何从种子生成 ECDSA 密钥并不能弥补这一差距;
用链本身的吞吐量为迁移给出界,并计算该界;
权衡核心争议——是否冻结量子脆弱的币——以及时间表中真实存在的不确定性。
28.3区块链的威胁模型#
直接的迁移压力落在签名和基于配对的公钥系统上。Shor 算法(第 1 章)威胁 Bitcoin 的 ECDSA 和 Schnorr、Ethereum 的账户 ECDSA 和共识 BLS 签名,以及 SNARK 和 KZG 系统背后的公钥假设 [1, 2]。Grover 算法对哈希造成的是平方根级而非指数级的削弱,但哈希仍需要针对具体性质和输出长度进行评估:例如 HASH160 只有名义上 \(2^{80}\) 的量子原像安全余量。
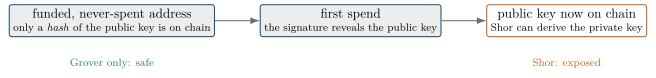
支配一切的微妙之处在于公钥何时变得可见。P2PK 和 P2TR 在 UTXO 创建时就暴露公钥或调整后的(tweaked)公钥;P2PKH 和 P2WPKH 通常在首次花费时才揭示公钥,而地址重用会使之后的输出处于暴露状态。其他脚本必须按其实际执行路径和见证数据来评估。
28.4Bitcoin#
28.4.1哪些内容已暴露#
Bitcoin 的暴露程度恰好是输出类型的函数。处于支付到公钥(P2PK,最早的、Satoshi 时代的输出)、裸多签以及 Taproot 密钥路径输出中的币,在链上永久携带公钥,属于长期暴露的脆弱币。处于哈希封装类型(P2PKH、P2SH、P2WPKH)中的币则一直受到保护,直到该地址被重用或被花费,此时密钥才被揭示 [3, 4]。BIP-361 指出,截至 2026 年 3 月 1 日,所有 bitcoin 中有超过 34% 已在链上揭示了公钥 [5];Chaincode Labs 的一项独立分析给出的暴露比例大致在供应量的五分之一到二分之一之间 [4]。(较早且被广泛转述的、将某一具体数额归于 Satoshi 时代 P2PK 的数字,最好视为估计值,而非既定事实。)
28.4.2两类暴露#
总体百分比掩盖了更有用的结构。已发表的、按成因拆分暴露供应量的链上分析,即便总量不尽相同,在定性形态上是一致的:其中大约四分之一到三分之一来自按设计公布密钥的输出类型(P2PK、裸多签、Taproot 密钥路径),而明显的多数——量级约为十分之七——来自普通的哈希封装地址,这些地址在被花费之后又被重用。图 28.1 描绘了这一机制;这种拆分则告诉我们每条分支被走到的频率。
这种区分之所以重要,是因为两种成因有不同的补救办法和不同的政治属性:
设计暴露是协议的属性。任何用户行为都无法撤销它——P2PK 输出的公钥永远留在账本中,所有者无法收回。只有迁移到新的输出类型才有帮助,而对于密钥已丢失的 P2PK 输出,则根本无济于事。
行为暴露是钱包使用方式的属性。它在原则上是可以避免的,至今仍随着每一次地址重用而不断累积,而且——至关重要的是——它正是教育、钱包默认设置和手续费政策能够在任何共识变更上线之前切实减少的那一部分。
实际的结论是:Bitcoin 量子暴露中最大的单一份额,并不需要软分叉就能开始缩小。它只需要钱包停止重用地址,而这一变更无需说服任何人去批准。任何不附带这种拆分的暴露数字,都会让问题看起来比实际情况更加普遍地难以解决。
注 1.1 (解读暴露统计数据). 链上暴露数字依赖于分析者。它们随以下因素而变化:如何处理粉尘输出和可证明不可花费的输出,地址是按余额还是按输出数量计数,以及如何对 Taproot 输出分类。应当像本节这样引用一个范围和出处,而不是单个精确到小数的数字。
28.4.3草案提案#
两项 Bitcoin 改进提案(BIP)构成了应对的支柱;截至 2026 年年中,两者均为草案状态且未激活:
BIP-360,“支付到 Merkle 根”(P2MR) [3]——此前以“支付到抗量子哈希”(P2QRH)之名流传——引入一种新的输出类型,拟以向后兼容的软分叉方式实施。按其当前形式,它本质上是去掉了密钥路径花费的 Taproot,从而永远不会承诺裸公钥;值得注意的是,当前草案把实际后量子签名方案的选择推迟到未来的提案(仅以 ML-DSA 和 SLH-DSA 为例),而不是强制指定某一方案。
BIP-361,“后量子迁移与遗留签名停用” [5]——即迁移与截止期限层。它提出分阶段停用 ECDSA/Schnorr:第一阶段(激活后约三年)停止向遗留地址类型发送资金,之后的一个旗帜日(约五年)则限制遗留签名,使得只有能够通过量子安全途径证明所有权的持有者才能继续移动这些币。
28.4.4签名方案的选择#
对 Bitcoin 而言,签名首先是一个经济对象,而不仅仅是密码学对象。用千字节量级的后量子签名替换几十字节的 ECDSA 或 Schnorr 签名,会改变交易权重、手续费、区块容量、存储、中继和同步。Falcon 因紧凑而颇具吸引力,但其采样器和数值实现要求更高;ML-DSA 结构更简单,但尺寸更大。因此,相关的比较必须同时包括线上占用和实现风险。
BIP-360 有意不指定方案,因此这个问题仍悬而未决,而非已有定论;本小节总结现有证据对它的约束。Blockstream Research 2026 年对格基候选方案的一篇评述 [6]专门针对 Bitcoin 对这一问题进行了详细推演。其核心框架是:对一条链而言,成本度量不是签名尺寸,而是公钥与签名的合计尺寸,因为一次花费会把两者都写入账本。在这一度量下,各方案的排名会发生变化。
| 方案 | NIST 级别 | \(|pk| + |\sigma|\) | 备注 |
|---|---|---|---|
Schnorr (secp256k1) |
— | \(96\) B | 现行方案;可被 Shor 攻破 |
| FN-DSA-512 (Falcon) | 1 | \(1563\) B | 已标准化方案中最小 |
| FN-DSA-1024 (Falcon) | 5 | \(3073\) B | |
| ML-DSA-44 | 2 | \(3732\) B | |
| ML-DSA-65 | 3 | \(5261\) B | |
| SLH-DSA-128s | 1 | \(7888\) B | 假设最为保守 |
| PORS+FP | 1 | \(3472\) B | 非标准;签名预算 \(2^{30}\) 次 |
从表 28.1 可以得出三个结论。
长期存在的输出的安全级别。#
一个 Bitcoin 输出可能在数十年内保持未花费,因此相关的安全时间跨度是输出的生命期,而不是创建它的软件的生命期。如果日后密码分析的进展使某个方案降到其预期类别之下,那么锁定在被削弱的密钥之下的币仍会处于暴露状态,第 28.4.6 节的冻结问题也会再次出现。大规模部署已经基于这些理由避免使用类别 1 的格参数:Apple 的 iMessage PQ3 使用类别 3 和类别 5,Cloudflare 将 X25519 与 ML-KEM-768 而非 ML-KEM-512 配对,两者都以在系统生命期内抵御密码分析进展的安全余量为理由。基于哈希的方案通常部署在类别 1,因为其底层假设比格假设更古老、研究得更充分。
安全余量的代价。#
处于类别 5 的 Falcon-1024,其合计占用(3073 B)小于类别 1 下最好的无状态基于哈希构造(7888 B),也小于类别 3 下的 ML-DSA-65(5261 B),后者是 Dilithium [7] 的标准化形式(第 17 章)。对 ML-DSA 而言,把类别从 2 提高到 3,每次花费约增加 1.5 kB。因此,Falcon 是唯一一个其最高安全类别仍小于所有其他方案较低类别的候选者。
缺少中间参数集。#
第 18 章的递归采样器在每一步都将环的次数减半,因此允许的次数都是 2 的幂,参数集从 \(n=512\)(约为类别 1)直接跳到 \(n=1024\)(高于类别 5)。不存在中间的环,因而也不存在中间的参数集;部署时必须在两者之中选择其一。
评估。#
该评述 [6]建议分阶段过渡。对于立即部署,它推荐基于哈希的方案,理由有二:哈希假设是各备选方案中最成熟的;FN-DSA 尚未成为最终标准(在本书的快照时间点,FIPS 206 仍在制定中,因此没有固定的规范、没有测试向量,也没有经过审计的库生态可供集成)。一旦 Falcon 完成标准化,它相对于所有基于哈希的备选方案的尺寸优势就会改变比较结果。这两个家族也可以结合使用:一个常见情形下签名较短的有状态基于哈希方案,可以把 Falcon 用作其无状态后备方案,用于罕见的恢复路径时,其尺寸远小于 SLH-DSA 后备方案。
注 1.2 (仅凭尺寸并不能决定选择). 表 28.1 中最小的条目本身并不决定推荐结果。Falcon 的占用最小,但其标准化状态也最不确定,实现最为精细(第 18.8 节),而且没有实用的钱包派生方式(第 28.4.5 节);这些正是该评述推荐基于哈希的家族用于立即部署的理由。
28.4.5钱包派生的缺口#
对这一选择还有第二个约束,而它根本不是尺寸问题。Bitcoin 钱包是分层确定性的:BIP-32 [8] 从一个主扩展公钥出发,仅使用公开数据即可派生出无限多个子公钥,整个过程完全不涉及秘密钥。正是这一点使得只读(watch-only)热钱包可以分发新地址,而种子始终保存在冷存储中;它也是几乎所有在用钱包的支柱。
已标准化的后量子签名方案没有一个支持这一点。 [6] BIP-32 的非强化派生是椭圆曲线群中的一次加法——子密钥 \(=\) 父密钥 \(+\) 调整值,在秘密端和公开端都是如此——而格方案并不能免费提供同样的结构。已知的替代方案都是研究性构造,而且代价高昂:
Dilithium 进展最快。其可再随机化密钥变体从一个公开的更新值派生子密钥,并保持两个密钥同步,合计占用约为 6.5 到 8.3 kB,具体取决于钱包是公布未压缩的密钥,还是在每个签名中附带一个修正项。障碍在于 ML-DSA 的公钥压缩不是可加的,因此不能简单地把更新值加到压缩后的父密钥上。
Falcon 只有一个已发表的构造,它对格基进行再随机化。这样做会放大签名范数界,使一个链上签名增大到约 23.7 kB,约为 Falcon-512 签名的 \(36\times\)——而且其给出的参数并不满足该方案自身的安全条件,因此修正后的版本还会更大。目前 Falcon 没有可行的公钥派生方法。
Dilithium 变体还带有一个部署假设,它与 ML-DSA 自身的一项设计决策正好相反。派生地址的不可关联性要求矩阵 \(A\) 在全网范围共享。这在模 LWE 下形式上是可靠的,但第 17 章恰恰是为了排除被植入后门的矩阵,并防止一次预计算可应用于多个目标,才从每个密钥各自的种子派生 \(A\)。对偶格攻击中的预处理只依赖于矩阵,因此单一的全网 \(A\) 会使一次大规模的约化工作同时作用于链上的每一个密钥。在 Dilithium-3 的维数下,这种攻击仍然遥不可及——但这一约定把整个网络的安全集中于一个实例之上,这与 FIPS 204 所选择的风险特征不同。
注 1.3 (这对迁移意味着什么代价). 第 28.10.1 节把每个输出的成本 \(w\) 视为协议可以协商的那一项。钱包派生提醒我们,\(w\) 并不是唯一的利害所在:一个没有非强化派生的方案,要么迫使采用不同的钱包架构(每个地址都从冷密钥预先派生并存储),要么迫使采用一个并非标准化版本的方案变体。两者都不是致命的,也都不是免费的,而且在一个止步于签名尺寸的比较中,两者都很容易被遗漏。
一种反复出现的安全机制是提交—揭示(commit–reveal):持有者先公布一个具有约束力的承诺,之后才将其揭示。它的设计目的,是在所述的确认深度、重组、手续费、超时和恢复假设下缓解抢跑(front-running);它并不是无条件的保证。
28.4.6冻结争议#
BIP-361 的停用机制意味着,所有者从未迁移的币——以及根本无法提供所有权证明的币,尤其是 P2PK——实际上将变得不可花费,即被冻结。这是 Bitcoin 路线图中最尖锐的未决争论。支持者认为,预先宣布的停用是一种防御:否则量子攻击者会直接盗走这些币,而冻结至少能保全它们。批评者则称任何强制迁移都带有没收性质,违背 Bitcoin 的产权精神,并警告说冻结长期休眠的币(包括 Satoshi 的币)会开创一个危险的先例。这是一场真实存在、尚未解决的政治分歧,而非既定计划,应当如此看待。
28.5Ethereum#
28.5.1哪些内容已暴露#
Ethereum 有四个不同的后量子迁移攻击面:基于 secp256k1/ECDSA 的账户授权、BLS 共识签名、用于数据可用性的 KZG 承诺,以及应用和 rollup 中基于配对或离散对数的证明系统。因此,一份只替换账户签名的路线图,仍会在协议栈中留下其他量子脆弱的假设。
一旦发送过一笔 ECDSA 交易,Ethereum 地址实际上就揭示了公钥。BLS 验证者签名、SNARK 验证器背后的配对曲线以及 KZG 承诺,都依赖于受 Shor 算法威胁的公钥假设 [1, 2]。比较 secp256k1 和 BLS12-381 的量子攻击成本需要针对具体群的资源估计;仅凭 381 位基域这个名称并不构成这样的估计。KZG 迁移必须区分 blob 的保留与承诺的绑定性、证明验证以及共识依赖;仅靠 blob 修剪并不能使风险变得轻微。
28.5.2双线计划#
Ethereum 的应对包括一条应急路线和一条结构性路线;目前尚无任何后量子功能上线主网。
量子紧急硬分叉。#
Vitalik Buterin 的提案“How to hard-fork to save most users’ funds in a quantum emergency”(如何在量子紧急状况下通过硬分叉挽救大多数用户的资金) [9]是一份应急预案。一旦出现大规模盗窃的证据,链将回退到盗窃发生前的最后一个区块,冻结遗留的 ECDSA 账户,并让用户通过一种新的交易类型找回资金;该交易携带一个 STARK 证明,证明发送者知道其地址背后的哈希原像秘密——即通过知晓哈希原像、而非通过 ECDSA 签名来进行认证。由于大多数用户的恢复秘密从未在链上暴露,这一方案能保护大多数人,代价是一次钱包软件更新。Buterin 指出,相关基础设施原则上现在就可以构建。
以账户抽象作为迁移载体。#
结构性计划是让账户自行选择签名方案。EIP-7702(“Set Code for EOAs”,Final 状态,已在 2025 年的 Pectra 升级中上线) [10]允许外部账户(EOA)委托给合约代码,从而将其变为具有任意验证逻辑的智能账户——不过 7702 授权本身是用 secp256k1 签名的,因此它只是一块垫脚石,本身并不是后量子迁移。专门的载体是 EIP-8141(“Frame Transaction”,Draft 状态,2026 年,Buterin 为合著者之一) [11],它明确将原生账户抽象描述为“a native off-ramp … to post-quantum secure systems”(一条通往后量子安全系统的原生出口匝道),在经典方案之外为任意(自定义的、后量子的)签名方案预留了一个位置。在共识层,计划是用 XMSS/Winternitz 家族的基于哈希的签名(第 19 章)取代 BLS 聚合,并在专门构建的零知识虚拟机中对其进行聚合。这两部分都已有公开原型:leanVM,它自称为“minimal hash-based zkVM, for a Post-Quantum Ethereum”(面向后量子 Ethereum 的极简基于哈希的 zkVM);以及 leanSig,即所提签名方案的 Rust 实现,其 README 明确声明它未经审计、不可用于生产 [12];计划还包括将 KZG 承诺迁移到基于 STARK 或基于格的替代方案;Ethereum 基金会公布的评估目标是在 2029 年前后实现第一层的后量子基础设施 [2]。2026 年 8 月,基金会宣布修订这一技术栈的密码学基础:证明系统将构建在二元域之上,从而使整个系统中的哈希函数——无论是在签名中、在 Merkle 承诺中,还是在 zkVM 自身的承诺方案中——都可以采用标准哈希(SHA-2 或 BLAKE 家族),而不是早期原型所依赖的 Poseidon 之类面向算术化的哈希。宣布的时间表是 2027 年推出生产级的 leanVM,2028 年在共识层部署 [13]。
28.5.3链上验证的选择#
结构性迁移路径可能会在链上引入后量子签名验证;应急路径则提出用 STARK 证明来证明对种子/原像的知识。这是两种不同的认证机制。它们的成本取决于方案、参数、实现、链以及 gas 计价表,因此任何基准测试在比较 gas 数字之前,都必须说明这些细节,包括代码提交版本和测量日期。
直接验证在合约中执行后量子验证器。基于证明的设计则证明验证已经发生,链上只检查该证明。后者同时改变了成本模型和假设;二层网络的组合问题在第 28.9 节展开,这类证明内部的后量子承诺选择则在第 28.9.5 节讨论。
| Bitcoin | Ethereum | Cosmos | |
|---|---|---|---|
| 最难的约束 | 治理 | 验证者规模下的签名尺寸 | 跨链异构性 |
| 保护资金的签名 | ECDSA / Schnorr (secp256k1) | ECDSA(账户);BLS12-381(共识) | ed25519(共识) |
| 当前已暴露 | P2PK、重用的 P2PKH、Taproot 密钥路径 | 任何发送过交易的账户 | 验证者密钥;账户密钥 |
| 选定的 PQ 方案 | 尚未选定 | 基于哈希(XMSS/Winternitz 家族) | ML-DSA-65(FIPS 204) |
| 迁移载体 | 新输出类型(BIP-360) | 账户抽象;zkVM 聚合 | 可选启用的密钥类型 \(+\) 密钥轮换 |
| 应急计划 | 遗留签名停用(BIP-361) | 带 STARK 恢复的紧急硬分叉 | 各链自行治理 |
| 分叉方式 | 软分叉 | 协议升级 / 紧急硬分叉 | 各链自定,创世参数 |
| 状态(2026 年年中) | BIP 草案,未激活 | 原型,未审计;PQ 基础设施 \(\sim\)2029 年 | 已在 SDK v0.55 中发布,默认关闭 |
28.6管理密钥:集中的情形#
到目前为止,我们都把威胁当作分散的:众多用户各自以自己的密钥持有自己的币,并按自己的节奏迁移。有一类目标完全颠倒了这一结构,而相对于其规模,它受到的讨论明显不足。
稳定币并不是原生资产,而是一个可升级的智能合约,其行为由少数几个特权角色控制,这些角色由普通的外部账户持有——也就是说,由带有普通链上公钥的普通 secp256k1 密钥持有。角色因发行方而异,但模式是一致的:
代理管理员(proxy admin),可以替换合约的实现,从而替换其全部逻辑;
铸币者或主铸币者角色,可以在没有相应储备的情况下发行代币;
黑名单管理者或冻结者,可以冻结余额;
暂停者,可以暂停所有转账。
这里的安全性质在三个方面不同于本章其余部分。密钥数量极少,因此攻击者只需执行少数几次 Shor 算法,而不必发动一场大规模行动。所控制的价值巨大且为众人共享——一旦失陷,受影响的不是一个钱包,而是该代币的所有持有者,连同所有把它当作抵押品的借贷协议、跨链桥和交易所。而且损害并不以余额为限,因为代理管理员可以改写记账规则,而不仅仅是转移资金。
在其他场合有效的两种缓解措施在这里无济于事。多签控制把私钥分给若干持有者,但量子攻击者可以从每个已公布的公钥分别独立推导出对应私钥,因此 \(m\)-of-\(n\) 方案只把攻击者的成本提高 \(m\) 倍,而非指数倍——这与用户钱包中提到的线性退化相同。硬件托管可以防止密钥从设备中被提取,而 Shor 算法并不从设备中提取密钥;它从账本中推导密钥。
可取之处在于,这是整个问题中唯一有责任方的部分。没有人能强迫数百万用户轮换钱包,但稳定币发行方可以按自己的时间表把自己的管理角色迁移到后量子授权——前提是链为其提供一条可以迁移过去的后量子验证路径,这又使问题回到了上文的协议路线图。集中控制既是这一暴露危险的原因,也是它成为本章中最易处理事项的原因。
28.7Cosmos#
Bitcoin 和 Ethereum 是量子讨论中通常被点名的链,而在这两条链上,后量子工作仍停留在提案阶段。在已发布代码方面走得最远的生态系统并不是它们中的任何一个。
28.7.1可选启用的后量子共识密钥#
Cosmos SDK v0.55 将 ML-DSA-65(FIPS 204,第 17 章)注册为一种受支持的验证者共识密钥类型 [14, 15]。这是代码树中的代码,而非草案:cosmos.crypto.mldsa65 proto 包、Amino 路由以及一个 x/auth 签名验证成本参数均已默认启用并发布,init 和 testnet 命令也接受 --consensus-key-algo ml_dsa_65。
默认启用并发布的是这一能力,而不是这一变更本身。genesis.consensus_params.validator.pub_key_types 的默认值仍为 ["ed25519"],因此现有链在其自身治理添加新类型之前不受影响。由于验证者共识密钥轮换在同一版本中一并发布,现有链可以通过添加该类型并让验证者轮换密钥来采用后量子密钥,而不必重新启动一个新的创世。这是一条比旗帜日温和得多的迁移路径。
28.7.2尺寸的实际代价#
其运营后果被直白地说明了,而它们与塑造本章每一份路线图的物理事实相同:一个 ML-DSA-65 公钥为 1952 字节,而 ed25519 为 32 字节;一个签名为 3309 字节,而 ed25519 为 64 字节——分别约为 \(60\times\) 和 \(50\times\)。CometBFT 的最大签名尺寸和每个验证者的提交签名预算都不得不提高以容纳它们,启用该类型的链也被告知要重新审视其区块大小和 gossip 帧限制。每个验证者都要为每个区块签名,因此这一负担直接落在共识的热路径上。
这两个数字正是 FIPS 204 为 ML-DSA-65 规定的值,读者可以自行验证而不必轻信:第 17 章的实现从参数集推导出了这两个数, \[|pk| = 32 + 32k(\mathrm{bitlen}(q-1) - d) = 1952,\] 签名长度则以同样方式由 \(\lambda\)、\(\ell\)、\(\gamma_1\)、\(\omega\) 和 \(k\) 得出。
28.7.3互操作性风险#
Cosmos 暴露出一个单体链永远不会遇到的迁移问题,而这也是本章最具可迁移性的教训。对手方链上的 IBC 轻客户端使用对手方自身编译进来的密码学代码来验证你的验证者集合的提交签名。如果持有足够投票权的验证者开始使用对手方无法验证的密钥类型签名,那么区块头在对手方那里就会验证失败,与该链的数据包流转随之停止,轻客户端最终过期 [14]。对手方只需要验证代码,而不需要该密钥类型本身——但它确实需要这段代码,而且必须先具备。
因此,在一个可互操作的生态系统中,后量子迁移首先是一个协调问题,其次才是密码学问题,而且它的失败模式是静默的:升级的那一刻什么也没有坏,只是在之后,一条原本传输数据包的连接不再传输了。任何多链迁移计划都需要一套排序方案,而目前还没有任何已发表的方案能覆盖一个大型 IBC 图。
28.8种子、原像与 EdDSA 的不对称性#
到目前为止的每一条迁移路径,都要求所有者在攻击者之前采取行动。有一类机制则不然,它取决于密钥生成中的一个细节,而大多数读者从来没有理由注意到这个细节。
28.8.1恢复问题#
假设最坏的情况已经发生:量子攻击者已对某个暴露的公钥运行了 Shor 算法,并持有一个有效的私钥。链只能通过拒绝遗留签名来保护这些币——但这样一来,诚实的所有者也无法花费,因为其私钥恰恰就是攻击者现在拥有的那个。要找回这些币,所有者必须证明某样攻击者无法证明的东西:不是持有私钥(它已不再保密),而是持有私钥上游的某个秘密。
Ethereum 的应急计划(第 28.5.2 节)正是这一步:通过证明知道某个哈希原像、而非通过签名来进行认证。它之所以可行,是因为恢复秘密从未被公布,Shor 算法根本触及不到它。它之所以是临时拼凑的,是因为 Ethereum 必须专门安排这样一个秘密的存在。
28.8.2RFC 8032 在构造上就做了这一安排#
EdDSA 不需要这种安排,因为它的密钥生成本来就具有这种形态。在 RFC 8032 [16] 中,一个 Ed25519 密钥起始于一个 32 字节的种子 \(k\),签名标量则通过对其哈希而派生: \[h = \mathrm{SHA\text{-}512}(k), \qquad s = \mathrm{clamp}\big(h[0..31]\big), \qquad A = s\cdot B ,\] 上半部分 \(h[32..63]\) 则保留为确定性的随机数前缀。钱包存储的值是 \(k\);公钥所承诺的值是 \(s\)。
这一次哈希就是全部的不对称性所在。Shor 算法计算离散对数,因此攻击者可以从 \(A\) 恢复出 \(s\)——然后就止步于此,因为从 \(s\) 恢复 \(k\) 是对 SHA-512 的原像搜索,而 Grover 算法只能将其加速平方倍。即使曲线被彻底攻破,诚实的所有者知道 \(k\),而攻击者不知道。因此所有者可以用零知识方式证明 \[\exists\, k \;:\; \mathrm{clamp}\big(\mathrm{SHA\text{-}512}(k)[0..31]\big)\cdot B = A ,\] 从而把现有地址 \(A\) 绑定到一个新的后量子密钥上,而无需事先移动资金 [17]。
区别就在于最后一个从句:
预承诺方案——公布对未来后量子密钥的承诺,正如 BIP-360 的提交—揭示所做的那样——要求每一位所有者在 Q-Day 之前采取行动。
种子原像证明则允许所有者在 Q-Day 之后、此前什么都没做的情况下进行恢复。
考虑到 SegWit 在提供即时手续费折扣的情况下,仍花了三年多才达到交易量的 80%,“无需用户事先采取任何行动”并不是一项微不足道的便利。它决定了一种机制能否触及休眠的币。
28.8.3为何不直接从种子派生 ECDSA 密钥?#
一个显而易见的问题是:为什么 ECDSA 链不能采用同样的技巧——定义 \(sk = H(\text{seed}) \bmod n\),保留种子,日后再证明原像?从密码学上说,没有什么能阻止这样做。ECDSA 对标量如何产生不施加任何约束,因此该构造是可靠的,证明语句的形态也相同。
不仅如此,这件事早已有人做过。BIP-32 分层确定性钱包 [8]通过一连串 HMAC-SHA512 步骤从主种子派生出每一个签名密钥,而 BIP-39 又在此之前加上了助记词和 PBKDF2。当今存在的大多数 Bitcoin 和 Ethereum 密钥,在所有者抄写下来的秘密与其地址所承诺的标量之间,确实存在一次哈希。所谓 ECDSA 链缺少这一层的笼统说法,是关于协议的陈述;若作为关于钱包的陈述,则说得太过了。
尽管如此,这一缺口是真实存在的,而且它之所以有启发性,正是因为它根本不是一个密码学缺口。有三件事把协议不变量与一种广泛的惯例区分开来:
普遍性。RFC 8032 把“先种子、后哈希”作为 Ed25519 密钥生成的定义,因此每个符合规范的密钥都具有这一结构。在 ECDSA 中,这只是钱包的选择,而例外恰恰是那些高价值的历史情形:来自
dumpprivkey的早期 Bitcoin 密钥、脑钱包、纸钱包、由交易所和 HSM 生成的密钥,以及 2012 年 BIP-32 出现之前产生的一切密钥。可检测性。给定一个地址,链上没有任何信息能揭示它是否源自 BIP-32。共识规则无法为种子派生的密钥提供恢复路径而冻结其余密钥,因为它无法事先区分两者;原始熵密钥的所有者只有在尝试恢复的那一刻才会发现问题。
单一的待证语句。Ed25519 只需要一个电路。ECDSA 恢复则必须涵盖 BIP-32、SLIP-0010、Electrum 的方案以及原始熵,强化派生与非强化派生,以及任意派生路径——要么采用大得多的电路,要么把路径作为公开输入揭示出来;后者大概可以接受,但又多了一件需要规定并推动采用的事情。
而对于从现在起生成的密钥,这个想法就完全不成立了。改变密钥生成需要更新钱包软件;既然钱包无论如何都要更新,它就应该生成一个 ML-DSA 密钥,而不是一个巧妙派生的 ECDSA 密钥。种子原像路径只在追溯意义上有价值,适用于那些已经存放在其所有者无法或不愿采取行动的地址中的币——而这也并非巧合地正是本章其他每一种机制都无法触及的那个群体。
| EdDSA 链 | ECDSA 链 | |
|---|---|---|
| 种子到标量的哈希 | 由 RFC 8032 强制规定 | 钱包惯例(BIP-32/39) |
| 覆盖范围 | 每个符合规范的密钥 | 大多数,但并非全部,且不包括最早的密钥 |
| 链上可检测 | 是,由构造保证 | 否 |
| 待证明的派生 | 一个函数 | 多种方案,外加一条路径 |
| 可用作共识规则 | 有可能 | 不行,除非对它无法分类的密钥进行分类 |
28.8.4对两者都适用的注意事项#
有三个条件容易被忽视,而每一个都与本章其他部分的内容相关联。
这是恢复,而不是保护。#
只要遗留签名仍然有效,种子证明就毫无作用:攻击者持有一个可用的私钥,直接用它花费即可,速度快于所有者察觉。该机制只有在已经禁用遗留授权的链上才具有效力。因此它并不能回避第 28.4.6 节的冻结争议——它以停用之争已经胜出为前提。
证明系统本身必须是后量子的。#
在基于配对友好曲线的 Groth16 验证器内证明哈希原像,所得论证的可靠性会被 Shor 算法攻破,由此得到的系统并不比它所取代的 ECDSA 更好。这正是第 28.9.1 节所列举的错误:由椭圆曲线论证所承载的基于哈希的语句。必须使用 STARK 或其他基于哈希的证明系统,而且必须一查到底,包括其查找论证和内存论证。
证明必须与目的地绑定。#
恢复证明是公开发布的。如果一个证明只确立“有人知道 \(A\) 背后的种子”,而不承诺资金去向,那么监视内存池的攻击者就可以在一笔向自己付款的交易中重放它。证明语句必须包含目的地,这使它成为对恢复交易的签名,而不是一个游离的证明——这与上文讨论的提交—揭示构造面临的是同一种抢跑风险,也适用同一类修复方法。
注 1.4 (BIP-32 在 Shor 算法下会单独退化). 非强化的 BIP-32 派生令 \(k_{\text{child}} = k_{\text{parent}} + I_L\),其中 \(I_L\) 可以从父公钥和链码计算出来。账户级扩展公钥经常被分享给只读钱包和轻客户端服务器;面对 Shor 算法,这种暴露会泄露账户标量,进而泄露每一个非强化子密钥。主种子仍然安全,因此上面的恢复论证依然成立——但一次暴露的代价是整个账户分支,而不是一个地址。
28.9二层网络:组合问题#
上面三条链各自只迁移一个系统。二层网络则没有这样的便利。一个结算到 Bitcoin 的 rollup 或侧链,是由各自独立设计、按各自时间表迁移、由不同各方拥有的系统组合而成的:它结算到一个自己无法改变的基础层,通常从第三个生态系统借用共识栈,并运营一座信任根由其自行选择的密码学所构成的跨链桥 [18]。
这种组合改变了问题本身。对于单条链,人们可以合理地问“它何时会成为后量子安全的?”而对于二层网络,唯一可以回答的问题是:我们拥有哪些攻击面,其余攻击面上的剩余风险是什么?表 28.4 就是回答这一问题所需的清单。
| 攻击面 | 典型方案 | 受 Shor 威胁? | 谁能修复 |
|---|---|---|---|
| L1 结算输出 | secp256k1 / Schnorr | 是 | 仅基础层 |
| 跨链桥运营者密钥 | secp256k1、Schnorr、BLS | 是 | L2 |
| 跨链桥证明系统 | Groth16/PLONK,或 STARK | 需检查内部 | L2,通常需上游配合 |
| 跨链桥承诺 | Merkle、Winternitz | 否 | 已经安全 |
| L2 共识密钥 | ed25519、BLS12-381 | 是 | L2 的共识栈 |
| 合约管理 / 升级密钥 | secp256k1(常为多签) | 是 | 角色持有者,可单方面完成 |
| EVM 密码学预编译合约 | ecrecover、BN254 配对、KZG |
是 | 上游;无法迁移 |
28.9.1对称层的作用范围#
审计这样一个技术栈所得到的最有用的教训是一个否定性的教训,而且它的适用范围远远超出区块链:基于哈希的层或对称层只保护它所承载的东西。
以下是同一个错误的三个实例,全部来自同一座真实的跨链桥:
Bitcoin 一侧的比特承诺以 Winternitz 一次性签名(第 19 章)实现——基于哈希,确实是后量子安全的——但它承诺的是一个基于配对友好曲线的 Groth16 证明的各个元素。承诺本身能抵御 Shor 算法;被承诺的东西却不能。
一个混淆电路求值器由 AES 和一个哈希函数构建,因而通体是对称的,但它混淆的是一个 Groth16 验证器。混淆改变的是验证器如何执行,而不是它断言的内容。
一个基于 FRI 的 STARK,其多项式承诺是基于哈希的,却在其离线内存一致性论证中使用了椭圆曲线多重集哈希。量子攻击者从不攻击 FRI;它伪造的是内存检查 [19]。
在每个实例中,一个正确的陈述——“这一层是基于哈希的”——支撑了一个错误的结论。需要养成的习惯是追问一层承载的是什么,并一直追问下去,直到答案是一个困难性假设,而不是一个原语。
28.9.2一个证明系统中的多重假设#
第三个实例值得强调,因为它最不明显。一个证明系统不是一个假设,而是若干个假设,而最显眼的承诺方案只是其中最容易看到的一个。置换论证、查找论证和离线内存检查,都是椭圆曲线累加器可能藏身于一个原本基于哈希的系统之中的地方。
具体的例子是一个 zkVM,其多重集哈希把内存值映射到曲线点上,使得内存论证的可靠性明确依赖于离散对数——这一点由项目方自己记录在案,修复方法是采用 [20]意义上的基于格的多重集哈希(LtHash),并已有一个可运行的原型 [19]。这个故事令人鼓舞的部分在于,修复是在现有论证内部替换一个原语,而不是架构上的改变。值得警惕的部分在于,这一暴露只在该项目自己的问题跟踪系统中可见,而不出现在其依赖列表中。
28.9.3无法迁移的暴露#
表 28.4 中有一行的行为不同于其他各行。账户之所以能采用新的签名方案,是因为其所有者可以选择启用。预编译合约则不能:在 EVM 链上,椭圆曲线和配对预编译合约(ecrecover、BN254 群运算和配对运算、BLS12-381 套件、KZG 点求值)是共识规则,而调用它们的合约是不可变的字节码。每一个链上 SNARK 验证器都会调用配对预编译合约;这些代码无法升级,而且通常没有人有权升级它们。
因此,这种暴露在部署时就已固定。链一旦上线,唯一可做的就是清点——哪些已部署的合约依赖于哪个预编译合约,其中哪些对共识或跨链桥至关重要——而这一清点值得尽早进行,因为不可变的调用者现在就可以识别出来,日后却永远无法迁移。
28.9.4替代签名聚合#
一个聚合签名的跨链桥或共识层,从 BLS 获得了很大的常数因子收益:许多签名可以作为一个签名来验证。没有任何已标准化的后量子签名可以聚合。ML-DSA 和 SLH-DSA 都不支持聚合,因此简单的替换会把一个签名变成 \(N\) 个,每一个都比原先的大一到两个数量级——对于一个由二十名 ML-DSA-65 签名者组成的委员会,原来的几十字节会变成几十千字节。
这正是 Ethereum 在共识层遇到的同一堵墙,也是其解决方案选择在 zkVM 内聚合基于哈希的签名方案、而非直接替换的原因(第 28.5.2 节)。任何设计依赖于聚合的系统,都应当预期其后量子迁移是一项架构工程,而不是更换一种密钥类型。
聚合一词涵盖三种不同的需求,而针对每一种,后量子方案的选项各不相同。
用证明系统恢复聚合。#
Ethereum 的路线用证明取代聚合:每个验证者用基于哈希的方案签名,再由 zkVM 证明 \(N\) 个签名均已通过验证。它对任意 \(N\) 和任意消息集合都能恢复一个常数大小的对象,代价是一整条证明流水线,而且它是唯一一条有可信路径扩展到 \(N\) 为数十万量级的路线。
门限签名。#
大多数跨链桥和委员会设计所需的比一般聚合要少:许多签名者,一条消息,一旦达到门限数量的签名者签名即被接受。这正是门限签名天然具有的形态——\(n\) 方中的 \(t\) 方运行一个协议,在一个联合公钥下共同输出一个普通签名——而且与聚合不同,它对验证者毫无影响:无论签名集合多大,链仍然用标准验证器检查一个 FIPS 204 签名。2026 年的两个构造使这一点对 ML-DSA 变得具体,而它们恰好在对委员会最重要的维度上有所不同。Quorus [21]通过在多方计算中执行 ML-DSA 签名算法来支持任意 \(t\)-of-\(n\),每一轮拒绝采样中每一方的通信量约为 \(100\) kB;Celi 等人 [22]给出了一个更轻量的协议,但限于约六方,每方通信量高达 1 MB。两者产生的签名和密钥都与单签名者 ML-DSA 逐字节相同。对于几十个成员的签名集合,只有前者能够扩展。
代价是签名形态的改变,而非密钥类型的改变。如今每个委员会成员独立地离线签名,并由一个位图记录谁签了名;门限签名则以选定法定人数之间的实时多轮协议取而代之,于是一个原本能容忍活性问题的设计就多了一项签名时的可用性要求。而且这一切都尚未标准化:NIST 首次征集多方门限方案的文件 IR 8214C [23] 直到 2026 年 1 月才定稿。对于锚定或跨链桥的信任根而言,依赖一个没有 FIPS 编号的构造,既是技术决策,也是治理决策,这就支持了先迁移所有无需聚合的密钥的做法。
研究性方案说明了为何不存在通用的“门限包装器”。Threshold Raccoon 选择了一种为协作计算而设计的签名关系,并对参与者的响应进行掩码,使掩码只在聚合时相互抵消 [24]。Flood and Submerse 通过结合投影、高斯噪声和可验证秘密共享来解决分布式密钥生成和鲁棒签名问题,使隐藏的份额保持在正确性区域之内 [25]。在这两种情况下,轮数、通信量、鲁棒性和噪声预算都是构造本身的一部分,而不是实现细节。
事后聚合。#
听起来最好的选项——在不改变任何人签名方式的前提下,把 \(N\) 个现有签名压缩成一个小对象——效果却最差。针对 Fiat–Shamir-with-aborts 方案的第一个聚合签名 [26],用其作者的话说,报告的是“quite small compression rates”(相当小的压缩率),而且它聚合的是不同的消息,而委员会只有一条消息。这一方向上的有力结果——用 LaBRADOR 进行聚合(第 28.9.5 节)——适用于 Falcon 而不适用于 ML-DSA。如果可聚合性是首要需求,那么它就是决定采用哪一个后量子方案时的考量因素,而不是事后再去解决的问题。
28.9.5证明系统内部的承诺#
前面各小节的问题——每一层承载的是什么——同样适用于证明系统本身。在那里,它变成了关于多项式承诺的问题,因为量子攻击者正是在那里发动攻击:现代论证的其余部分都是对转录本的域算术。
一个在原生代码中运行很快的签名验证器,在算术电路中仍可能代价高昂。例如,Loquat 围绕 Legendre PRF 和一个多变量多项式承诺构建了简洁的验证关系 [27]。评估这样一条路线,需要考察约束数量、域兼容性、见证生成时间、证明尺寸、验证成本及其假设的成熟度——而不仅仅是 CPU 周期。
目前在用的承诺有两个家族,它们的区别在于所作的假设,而不在于运行速度。
基于哈希的承诺——FRI 及其后继者 STIR 和 WHIR——通过打开 Merkle 树来实现,因此其假设是随机预言机加上抗碰撞性,底下没有任何代数结构。正是这一点使 STARK 成为后量子安全的,也正因如此,第 28.9.1 节的内存检查问题是一个缺陷而非一种设计选择:一个椭圆曲线累加器被放进了一个其承诺根本不作此类假设的系统中。
基于格的承诺——LaBRADOR 一脉 [28]——使用 Ajtai 承诺进行承诺,它是第 13 章中模上的矩阵—向量乘积,通过环运算而非哈希来打开。打开过程中没有任何哈希。
Ajtai 承诺#
整个方案只是一行线性代数。固定第 13 章的环 \(R_q=\mathbb{Z}_q[X]/(X^d+1)\)——Greyhound 的实现取 \(d=64\)——以及一个范数界 \(\beta\)。
本节的图遵循格零知识文献 [29]的约定,而不是本书其他地方使用的带编号伪代码:先是一个声明哪些是公开信息、哪些是私有信息的头部,然后两方分列两栏,中间是它们之间的消息,验证者的检查汇集在结尾的 Accept iff(当且仅当……时接受)之下。对于这些协议,有意思的内容是谁知道什么、谁在何时发送,而这一约定正好能展示这些。
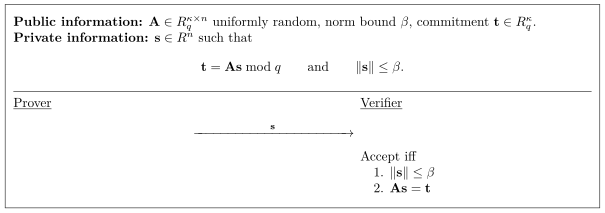
三条性质,每一条都起着实际作用。
压缩性。#
无论 \(n\) 有多大,承诺都是 \(\kappa\) 个环元素,因此 \(\kappa d\lceil\log_2 q\rceil\) 个比特可以代表任意长度的见证。还有第二条性质与之相伴:由于 SIS 的困难性不依赖于解的维数,加长见证也不会削弱假设,因此更长的见证既不耗费空间,也不损失安全性。 \(\mathbf{A}\) 是公共随机性,没有可信设置,也没有结构化参考串,与 Merkle 根完全一样。
绑定性。#
假设 \(\mathbf{s}\ne\mathbf{s}'\) 都能打开 \(\mathbf{t}\)。将两个验证方程相减得到 \[\mathbf{A}(\mathbf{s}-\mathbf{s}') = \mathbf{0} \bmod q, \qquad \mathbf{s}-\mathbf{s}' \ne \mathbf{0}, \qquad \|\mathbf{s}-\mathbf{s}'\| \le 2\beta ,\] 这恰好是界为 \(2\beta\) 的 Module-SIS 的一个解。
作为归约来看,这是紧的、直接的。针对绑定性的敌手被原样交给 M-SIS 矩阵(挑战分布与承诺密钥是同一个均匀的 \(\mathbf{A}\),因此无需模拟任何东西),而它的输出通过一次减法就转化为一个解。这里没有回卷,没有随机预言机,也没有损失: \(\mathrm{Adv}^{\mathrm{bind}} \le \mathrm{Adv}^{\text{M-SIS}}_{2\beta}\)。
与 Merkle 承诺的比较是双向的。这里的绑定性依赖于一个特定代数问题的困难性,即固定环、固定界下的 Module-SIS,而 Merkle 承诺只要求某个哈希函数是抗碰撞的;在这个意义上,格假设是更强的假设,而本节前面的那些失败恰恰源于结构。另一方面,M-SIS 是一个可证伪的、参数化的假设,通过紧归约来使用;而 STARK 的可靠性论证要经过随机预言机模型——这是对哈希的理想化,而不是关于哈希的假设——以及其邻近性证明中的邻近间隙猜想。格承诺假设得更多,但精确陈述了它所假设的内容;基于哈希的承诺假设得更少,但借助的是一个无法被证伪的模型。
隐藏性。#
按图示,图 28.2 是 \(\mathbf{s}\) 的一个确定性函数:它具有绑定性,但明确地不具有隐藏性,因为检验一个猜测只需重新计算 \(\mathbf{A}\mathbf{s}\) 并进行比较。这种精简形式正是简洁论证所使用的形式,原因将在下文说明。完整地陈述时,Ajtai 方案在消息 \(\mathbf{s}_1\) 之外还携带随机性 \(\mathbf{s}_2\),两者都是短的: \[\mathbf{A}_1\mathbf{s}_1 + \mathbf{A}_2\mathbf{s}_2 = \mathbf{t} \bmod q .\] 绑定性仍然是与之前相同的减法论证。隐藏性现在成立,是因为 \((\mathbf{A}_2,\mathbf{A}_2\mathbf{s}_2)\) 与均匀分布不可区分,这就是判定性模 LWE(第 13 章)。绑定性来自 SIS,隐藏性来自 LWE——第 II 部分的两个困难问题各占其一,作用于同一个矩阵。
另一种选择是 BDLOP 承诺,其中只有随机性 \(\mathbf{s}\) 需要是短的,消息可以是模 \(q\) 下的任意值: \[\begin{bmatrix}\mathbf{A}\\ \mathbf{B}\end{bmatrix}\mathbf{s} \;+\;\begin{bmatrix}\mathbf{0}\\ \mathbf{m}\end{bmatrix} \;=\;\begin{bmatrix}\mathbf{t}_A\\ \mathbf{t}_B\end{bmatrix} \bmod q .\] 这两种方案以一种决定了构建于其上的协议形态的方式相互权衡。Ajtai 要求消息是短的,但消息的维数完全不会增大承诺——而且由于 SIS 的困难性实际上并不依赖于解的维数,更长的见证也不会损失安全性。BDLOP 接受任意消息,并允许以每个元素一个环元素的代价追加更多元素,但其承诺和打开都随消息线性增长。因此,一个适用于系数小的长见证,另一个适用于系数大的短见证,而协议两者都需要:Lyubashevsky、Nguyen 和 Plançon 因此将它们融合为单一的 ABDLOP 承诺 [29],把长见证放在 Ajtai 部分,把协议积累的低维辅助项放在 BDLOP 部分;由于同一个 \(\mathbf{t}_A\) 同时服务于两者,Ajtai 承诺便顺带免费获得了。
两条性质都是计算性的,而这是被迫的而非选择的结果:没有任何承诺能同时具有统计绑定性和统计隐藏性,因为无界敌手总能攻破没有付出代价的那一条。把随机性提升到统计隐藏(对 \(R_q\) 的一个正则性论证)会使它变长,而打开又必须保持短,绑定性才能起作用,因此参数之间相互牵制。
这就是为什么本节中出现的是精简形式。一个证明系统只有在需要零知识时才需要隐藏性那一半,而这些证明系统默认并不需要——LaBRADOR 和 Greyhound 是知识论证,零知识是一个需要付出代价的可选变体。在假定格论证中的“承诺”隐藏了任何东西之前,值得了解这一点:它通常是用来约束证明者的,而不是用来保守秘密的。
线性同态性与范数增长。#
\(\mathbf{A}\mathbf{s}_1+\mathbf{A}\mathbf{s}_2=\mathbf{A}(\mathbf{s}_1+\mathbf{s}_2)\),这正是见证之所以能够被折叠和批处理的原因。但界也随之变化:和的打开的范数可达 \(2\beta\),经挑战加权的组合则更大,每一轮折叠都必须为这种增长留出预算。在 Merkle 树中,打开是精确的,组合是免费的。而在这里,范数就是货币,参数就是一份范数预算。
打开问题#
请注意图 28.2 没有提供的东西:打开它意味着发送 \(\mathbf{s}\),即它的全部 \(n\) 个环元素。承诺是短的,但其打开与见证一样长——这与 Merkle 树恰恰相反,后者的承诺是短的,而且打开是对数长度的,代价是每层一次哈希。
因此,格简洁论证的核心问题是:在不发送短打开的情况下,让验证者相信它存在。LaBRADOR 的答案是递归——把 \(R_q\) 上的一个二次关系系统归约为一个形态相同的更小系统,进行承诺,然后重复,使转录本成为一串承诺而不是一个见证。
LaBRADOR 论证#
LaBRADOR [28] 是针对一种固定形态语句的知识证明,这种语句称为点积约束系统:见证是 \(r\) 个短向量 \(\mathbf{s}_1,\dots,\mathbf{s}_r\in R_q^{n}\),满足 \(\sum_i\|\mathbf{s}_i\|^2\le\beta^2\),约束则是关于内积为二次的多项式恒等式, \[\sum_{i,j} a_{ij}\,\langle \mathbf{s}_i,\mathbf{s}_j\rangle \;+\;\sum_i \langle \boldsymbol{\varphi}_i,\mathbf{s}_i\rangle \;+\; b \;=\; 0 \qquad\text{in } R_q ,\] 每条约束对应一个这样的方程。一条约束的公开数据分为三类。\(a_{ij}\in R_q\) 是二次项(即两个见证向量的内积)上的标量系数。每个 \(\boldsymbol{\varphi}_i\in R_q^{n}\) 是一个与 \(\mathbf{s}_i\) 等长的公开向量,使得 \(\langle\boldsymbol{\varphi}_i,\mathbf{s}_i\rangle\) 是 \(\mathbf{s}_i\) 的线性项;元组 \((\boldsymbol{\varphi}_1,\dots,\boldsymbol{\varphi}_r)\) 是该约束的线性系数向量。而 \(b\in R_q\) 是常数项。因此,一条约束是见证的一个二次型,其唯一的非线性来自内积;纯线性约束就是每个 \(a_{ij}\) 都为零的情形。
两个例子说明如何把一个语句写成这种形式。Ajtai 承诺的打开,即 \(\mathbf{A}\mathbf{s}=\mathbf{t}\)(其中 \(\mathbf{A}\in R_q^{\kappa\times n}\)),是 \(\kappa\) 条线性约束,其中第 \(k\) 条满足 \(r=1\),\(\boldsymbol{\varphi}_1\) 等于 \(\mathbf{A}\) 的第 \(k\) 行,且 \(b=-t_k\);\(\mathbf{s}\) 的短性不是一条约束,而是随系统一同携带的范数界 \(\beta\)。关于一个内积的断言,例如 \(\langle\mathbf{s}_1,\mathbf{s}_2\rangle=v\),是一条二次约束,其中 \(a_{12}=1\),没有线性部分,且 \(b=-v\)。R1CS 以及格签名的验证方程,都可以用同样的方式转化为这类约束的集合;正是这一点使 LaBRADOR 成为一种通用论证,而不是对某一个关系的证明。
划分为二次部分和线性部分并非表面文章,因为协议对两者的处理方式不同。二次项通过对内积 \(g_{ij}=\langle\mathbf{s}_i,\mathbf{s}_j\rangle\) 本身进行承诺来处理。线性项则不能以同样方式承诺,因为在摊销之后,验证者持有的是单个组合 \(\mathbf{z}=\sum_ic_i\mathbf{s}_i\),而交叉项 \(\langle\boldsymbol{\varphi}_i,\mathbf{s}_j\rangle\) 会混合在一起;证明者对混合值 \(h_{ij}\) 进行承诺,而验证者必须自己构造组合系数向量 \(\sum_ic_i\boldsymbol{\varphi}_i\)。构造它需要触及每一个 \(\boldsymbol{\varphi}_i\),而所有 \(\boldsymbol{\varphi}_i\) 加起来与公开语句一样大,这就是下图中线性验证者的由来。
协议的一轮把一个这样的语句转化为一个形态相同的更小语句,而证明就是不断重复这一过程、直到语句小到可以直接明文回答为止的转录本。
承诺。证明者用 Ajtai 承诺 \(\mathbf{t}_i=\mathbf{A}\mathbf{s}_i\)(图 28.2)对每个 \(\mathbf{s}_i\) 进行承诺,然后把所有 \(\mathbf{t}_i\) 组成的向量拆分为短数字后再承诺一次,从而发送的是一个短的外层承诺,而不是 \(r\) 个内层承诺。对二次约束将要用到的内积 \(g_{ij}=\langle\mathbf{s}_i,\mathbf{s}_j\rangle\) 也做同样处理。
通过投影证明范数。验证者发送元素取自 \(\{-1,0,1\}\) 的随机矩阵 \(\Pi_i\),证明者返回投影 \(\mathbf{p}=\sum_i\Pi_i\mathbf{s}_i\),这是一个由 \(256\) 个整数组成的向量,与 \(r\) 和 \(n\) 无关。根据 Johnson–Lindenstrauss 引理,\(\|\mathbf{p}\|\) 以压倒性概率处于 \(\sqrt{\smash[b]{\textstyle\sum_i\|\mathbf{s}_i\|^2}}\) 的常数倍范围之内,因此一个短的 \(\mathbf{p}\) 能以与见证大小无关的代价证明范数界。验证 \(\mathbf{p}\) 确实是该投影,本身就是关于各 \(\mathbf{s}_i\) 的一条线性约束,并被折叠到下一步之中。
聚合与摊销。验证者发送随机权重,所有约束被合并为少数几条。随后它发送短多项式挑战 \(c_1,\dots,c_r\),证明者以单个向量 \(\mathbf{z}=\sum_i c_i\mathbf{s}_i\) 作答。验证者检查 \(\mathbf{A}\mathbf{z}=\sum_i c_i\mathbf{t}_i\)——同态性使这一检查无需看到任何 \(\mathbf{s}_i\) 即可进行——并利用 \(\langle\mathbf{z},\mathbf{z}\rangle=\sum_{i,j}c_ic_j\,g_{ij}\),对照 \(\mathbf{z}\) 和已承诺的 \(g_{ij}\) 检查合并后的约束。
递归。验证者此时持有的是这样一个断言:\(\mathbf{z}\) 连同外层承诺的打开是短的,并满足一个点积约束系统——与输入形态相同,只是 \(r\) 个见证向量被替换为一个(外加各承诺的数字向量),且范数界按挑战的大小有所增长。证明者不发送 \(\mathbf{z}\),而是把这个新语句作为下一轮的输入。
图 28.3 按本节其余部分的约定写出了一轮协议。
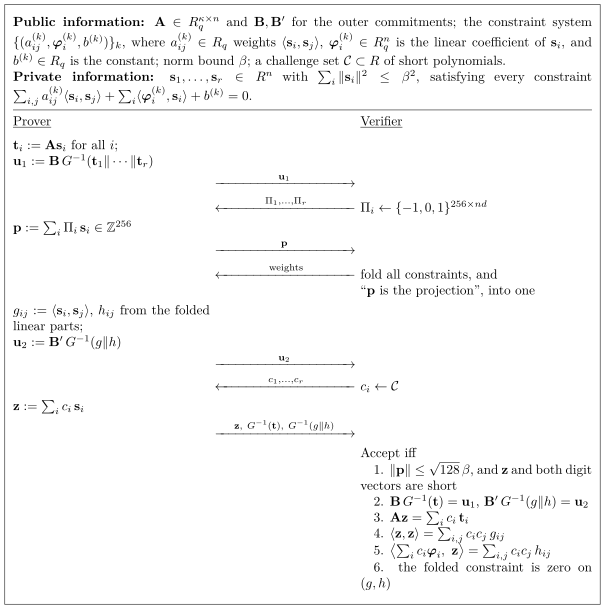
每一轮大致按摊销所带来的因子 \(r\) 缩小见证,整个转录本由每轮少数几个承诺和一个 \(256\) 项的投影组成,再加上最后以明文发送的小见证。尺寸就是这样来的:对于一个含 \(2^{20}\) 条约束的 R1CS 实例,在 128 位安全级别下约为 \(58\) kB,在经过几轮之后基本与语句规模无关。验证者的代价也是这样来的:为了检查合并后的约束,验证者必须在原始公开语句上构造 \(\sum_i c_i\boldsymbol{\varphi}_i\),因此即便证明不是线性的,它的工作量仍与语句成线性关系。Greyhound(见下文)是提供亚线性验证者的构造,它只用 LaBRADOR 来压缩其转录本。
上面的概述把两篇论文压缩成了一页。对同一路径的讲座篇幅的讲解——先是 Ajtai 承诺和 Lyubashevsky 风格的证明,然后是 LaBRADOR,然后是 Greyhound,再到 LaBRADOR 和 Greyhound 的概念验证实现——连同幻灯片、录像和参与者笔记,见 ZKP Academy 的格课程 [30];对于希望完整而非概要地了解这些协议的读者,它是本节推荐的配套材料。
从这样一个证明中进行提取是有代价的。它并不会交还被承诺的那个见证。它得到的是一个 \(\bar{\mathbf{s}}\) 和一个短多项式 \(c\),满足 \[\mathbf{A}\bar{\mathbf{s}} = c\,\mathbf{t} \bmod q, \qquad \|\bar{\mathbf{s}}\| \ \text{larger than}\ \|\mathbf{s}\| ,\] 这是一个不同的方程:范数增大了,并且出现了一个未知的乘数。这一差距称为松弛(slack),它不是可以日后再去收拾的证明瑕疵。
有两个后果说明了原因。在实践上,位于这类证明下游的方案会继承这个 \(c\)。在格可验证加密中,多年来这一直是解密者必须猜测 \(c\) 才能解密的原因,这使得期望解密时间随敌手的运行时间而变化——因此该方案只能部署在攻击者时间可以被限定的场合 [29]。在参数上,松弛会层层累积:更大的提取解要求更大的模数以保证 SIS 安全,而这又要求更大的维数以保证 LWE 安全,从而又使一切再次变大。聚合 Falcon 签名时遇到的也是这同一堵墙:LaBRADOR 的范数检查被证明“both approximate and with respect to the entire witness”(既是近似的,又是针对整个见证的),松弛随签名数量增长,迫使第一次迭代被替换为一个精确的短性证明 [31]。过去十年这一领域的大量工作都致力于减小或消除松弛。
从承诺到多项式承诺#
图 28.2 承诺的是一个向量。证明系统需要承诺一个多项式 \(f\),然后让验证者相信在承诺之后才选定的点 \(x\) 处有 \(f(x)=y\)——这就是多项式承诺方案,即 PCS。它有两项要求:它是绑定的,因此没有证明者能在同一点给出两个不同的值;它是简洁的,因此承诺和求值证明都远小于 \(f\) 本身。
多项式承诺作为迁移的单元。#
大多数现代论证系统——STARK、PLONK 及其后继者——都可以分解为两个独立部分:
一个多项式交互式预言机证明,其中证明者交给验证者一些多项式的理想化预言机,验证者对其进行查询。这一半是信息论意义上的:它不作任何假设,量子攻击者对它毫无优势。
一个编译器,把每个预言机替换为一个多项式承诺,把每次交互替换为 Fiat–Shamir。
系统中的每一个计算性假设都是通过第二步进入的。这就是为什么“这个证明系统是后量子安全的吗?”几乎总是一个关于其 PCS 的问题,也是为什么本节前面提到的 Ziren 修复是一次原语替换而不是重新设计:承诺之上的协议并不知道、也不关心承诺是由什么构成的。
| PCS | 承诺是 | 依赖于 | 设置 | 能抵御 Shor? |
|---|---|---|---|---|
| KZG | 一个群元素 | 配对;离散对数 | 结构化,可信 | 否 |
| FRI / WHIR | 一个 Merkle 根 | 随机预言机;抗碰撞性 | 透明 | 是 |
| Ajtai | \(\mathbf{t}=\mathbf{A}\mathbf{s}\),\(\kappa\) 个环元素 | Module-SIS(编译后另加随机预言机) | 透明 | 是 |
平方根分解。#
对于格这一行,从图 28.2 到 PCS 的桥梁是一次重排。记 \(f(X)=\sum_{i<N} f_i X^{i}\),其中 \(N=n\cdot m\),把系数排成一个 \(n\times m\) 矩阵 \(M\),令 \(M_{i,j}=f_{i+jn}\),于是求值可以分解为: \[f(x)\;=\;\sum_{j<m} x^{jn} \sum_{i<n} f_{i+jn}\,x^{i} \;=\;\mathbf{a}(x)^{\!\top} M\, \mathbf{b}(x), \qquad \begin{aligned} \mathbf{a}(x)&=(1,x,\dots,x^{n-1}),\\ \mathbf{b}(x)&=(1,x^{n},\dots,x^{(m-1)n}). \end{aligned}\] 这是一个二次型,而线性同态的承诺可以穿过它的一侧。
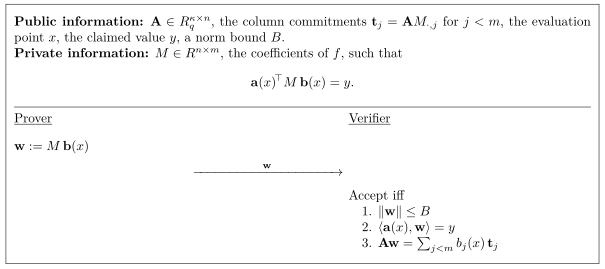
转录本和验证者都是 \(O(\sqrt{N})\) 的:证明者发送一列的数据量而不是整个矩阵,验证者执行 \(O(\sqrt{N})\) 次环运算而不是读取 \(f\)。
为什么真正的协议有三轮。#
该图展示的是思路,距离一个协议还差一步。\(\mathbf{b}(x)\) 的各项是 \(x\) 的幂,并不小,因此 \(\mathbf{w}=M\mathbf{b}(x)\) 也不短,检查 1 在任何有用的界下都无法满足。因此,真正的实例化会插入一轮:验证者发送一个短的随机挑战,证明者以经其加权的组合作答,响应便保持在范数预算之内。这额外的一轮就是示意图与 Greyhound 之间的差别;困难在于范数界,而不在于代数。图 28.5 给出了 Greyhound 实际运行的协议。它与草图还有另外两点不同:哪些是公开的,以及挑战落在二次型的哪一侧。
内层承诺与外层承诺。#
图 28.4 把列承诺 \(\mathbf{t}_j\) 列为公开信息。在 Greyhound 中它们并不公开;公开的只是对它们的一个承诺。原因在于尺寸。每个 \(\mathbf{t}_j=\mathbf{A}\mathbf{f}_j\) 都是对一个短列的绑定性 Ajtai 承诺,但它们共有 \(m=O(\sqrt{N})\) 个,因此由所有 \(\mathbf{t}_j\) 构成的对 \(f\) 的承诺长度将是 \(O(\sqrt{N})\)。因此 Greyhound 承诺两次:内层承诺 \(\mathbf{t}_j=\mathbf{A}\mathbf{f}_j\),以及一个对它们全部拼接的外层承诺 \[\mathbf{u}\;=\;\mathbf{B}\,G^{-1}(\mathbf{t}_1\|\cdots\|\mathbf{t}_m)\] 小工具逆(gadget inverse)\(G^{-1}\) 不是可有可无的:各 \(\mathbf{t}_j\) 是模 \(q\) 均匀的,而 Ajtai 承诺只绑定短输入,因此要先把它们拆分为短数字,由 \(\mathbf{B}\) 承诺的是数字向量。多项式承诺就是 \(\mathbf{u}\),无论 \(N\) 多大,它都只有少数几个环元素;各 \(\mathbf{t}_j\) 在求值证明中被揭示,并据此进行检查。这与第 28.9.5 节 LaBRADOR 概述第 1 步中的两级模式相同。
挑战落在何处。#
必须是短的那个响应,是以短挑战加权的各列的组合 \(\mathbf{z}=F\mathbf{c}\);部分求值 \(w_j=\langle\mathbf{a}(x),\mathbf{f}_j\rangle\) 以明文发送,根本不需要是短的,因为 \(\mathbf{z}\) 会把它们钉住。
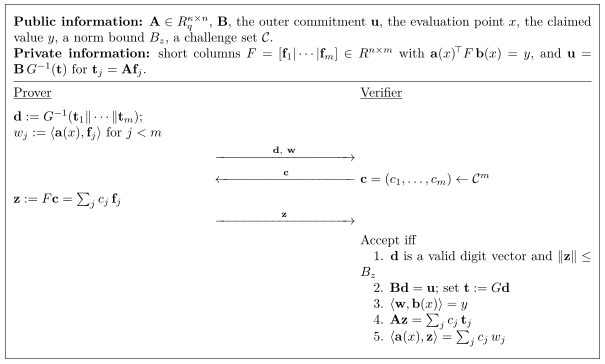
SageMath 实验:承诺与求值协议#
这两幅图都短到可以直接运行。第一个代码清单是在一个玩具版环 \(R_q=\mathbb{Z}_{12289}[x]/(x^{16}+1)\) 中实现的图 28.2,取 \(\kappa=2\)、\(n=8\):一个均匀随机的 \(\mathbf{A}\),一个三元见证,承诺 \(\mathbf{t}=\mathbf{A}\mathbf{s}\),以及验证者的两项检查。这些参数对安全性而言太小了;之所以这样选取,是为了让每个对象都可以打印出来。
# The Ajtai commitment in a toy ring: t = A s with s short.
q, d, kappa, n = 12289, 16, 2, 8
R.<x> = PolynomialRing(GF(q)); Rq.<X> = R.quotient(x^d + 1)

def centered(v):        # coefficients of a ring element in (-q/2, q/2]
    return [c - q if c > q // 2 else c for c in map(Integer, v.lift().list() + [0]*d)][:d]
def norm2(vec):         # squared Euclidean norm of a vector of ring elements
    return sum(c^2 for v in vec for c in centered(v))
def short(k, bound=1):  # k ring elements with coefficients in [-bound, bound]
    return vector(Rq, [Rq([randint(-bound, bound) for _ in range(d)]) for _ in range(k)])

A = random_matrix(Rq, kappa, n)      # public randomness, no trapdoor
s = short(n)                          # the witness
t = A * s                             # the commitment: kappa ring elements
beta2 = n * d                         # every coefficient at most 1 in size

def open_ok(t, s):                    # the verifier of Figure 28.2
    return A * s == t and norm2(s) <= beta2

print("opens:", open_ok(t, s))
s_long = short(n, bound=q // 4)       # long vectors fail the norm check, whatever A s is
print("long vector passes the norm check:", norm2(s_long) <= beta2)
第二个代码清单接续第一个,运行图 28.5:一个由短环元素组成的 \(n\times m\) 矩阵 \(F\),\(m\) 个内层承诺,到 16 进制数字的小工具分解以及外层承诺 \(\mathbf{u}\),然后是三轮交互和五项检查。digits 即 \(G^{-1}\),undigits 即 \(G\);除了通过 \(\mathbf{u}\) 和交给它的数字之外,验证者从未看到 \(F\) 或各 \(\mathbf{t}_j\)。篡改一个部分求值会使检查 5 失败,这正是 \(\mathbf{z}\) 所强制的一致性。
# The square-root PCS: inner and outer commitments, then the
# three-round evaluation protocol.  Continues from the Ajtai listing.
m = 4                                  # F is n x m: N = n*m short ring elements
ell, base = 4, 16                      # 16^4 > q: four digits per coefficient

def digits(vec):                       # G^{-1}: split each coefficient in base 16
    out = []
    for v in vec:
        cs = [Integer(c) for c in v.lift().list() + [0]*d][:d]
        for j in range(ell):
            out.append(Rq([(c >> (4*j)) & 15 for c in cs]))
    return vector(Rq, out)
def undigits(dv):                      # G: the inverse map
    return vector(Rq, [sum(dv[i*ell + j] * base^j for j in range(ell))
                       for i in range(len(dv) // ell)])

B = random_matrix(Rq, kappa, kappa * m * ell)   # for the outer commitment
F = matrix(Rq, n, m, lambda i, j: short(1)[0])  # the committed coefficients
T = [A * F.column(j) for j in range(m)]         # inner commitments t_j
tvec = vector(Rq, sum((list(t) for t in T), []))
u = B * digits(tvec)                             # outer commitment: the PCS commitment

xpt = Rq.random_element()                        # evaluation point
a = vector(Rq, [xpt^i for i in range(n)]); b = vector(Rq, [xpt^(n*j) for j in range(m)])
y = a * F * b                                    # the claimed value f(x)

# Round 1: prover sends the digits and the partial evaluations.
dvec = digits(tvec); w = vector(Rq, [a * F.column(j) for j in range(m)])
# Round 2: verifier sends a short challenge.  Round 3: prover answers with z.
c = short(m); z = F * c

def verify(dvec, w, c, z):                       # the five checks of the evaluation figure
    digit_ok = all(0 <= Integer(v) < base for dd in dvec for v in dd.lift().list())
    tv = undigits(dvec); tj = [tv[i*kappa:(i+1)*kappa] for i in range(m)]
    return (digit_ok and norm2(z) <= n * d * (m * d)^2   # 1. digits and shortness
            and B * dvec == u                    # 2. outer commitment opens
            and w * b == y                       # 3. the evaluation
            and A * z == sum(c[j] * tj[j] for j in range(m))   # 4. inner homomorphism
            and a * z == sum(c[j] * w[j] for j in range(m)))   # 5. w is consistent with z

print("honest transcript verifies:", verify(dvec, w, c, z))
w_bad = vector(Rq, list(w)); w_bad[0] += 1
print("with a tampered partial evaluation:", verify(dvec, w_bad, c, z))
这个实验没有做的是压缩:证明者以明文发送 \(\mathbf{d}\)、\(\mathbf{w}\) 和 \(\mathbf{z}\),共 \(O(\sqrt{N})\) 个环元素,验证者执行 \(O(\sqrt{N})\) 次环乘法。Greyhound 剩下的一步,是把这五项检查作为关于 \(\mathbf{d}\) 和 \(\mathbf{z}\) 的点积约束系统交给 LaBRADOR(第 28.9.5 节),由它把转录本缩小到几十千字节。
范数检查的作用。#
没有范数检查,就根本没有承诺。映射 \(\mathbf{s}\mapsto\mathbf{A}\mathbf{s}\) 从 \(R_q^{n}\) 到 \(R_q^{\kappa}\)(其中 \(n\gg\kappa\))是极度非单射的——每个 \(\mathbf{t}\) 大约有 \(q^{d(n-\kappa)}\) 个原像,高斯消元能在多项式时间内找到一个。只要允许用一个大向量作答,任何人都可以把 Ajtai 承诺打开成任何想要的东西。
困难的是找到一个短原像,而为同一个 \(\mathbf{t}\) 找到两个短原像,恰恰就是上文绑定性论证中的 Module-SIS 问题。因此范数界不是方案的附带条件;它就是方案本身。每一轮中的每一条消息都带有一个范数界,每一个组合消息的操作都必须计入增长,而一个协议只要在任何一处丢失了对某个界的跟踪,就在所有地方丢失了绑定性。这就是为什么格论证读起来像一道记账练习,也是为什么上一小节中的提取松弛是一种自然的失败模式,而不是一个意外。
与 FRI 的比较。#
其机制与 FRI 的差别,比它们共有的“后量子”标签所暗示的要大。FRI 从不证明代数恒等式:它通过折叠被承诺的字并打开少数几个位置,来确立该字接近某个低次码字,因此其代价以查询次数和 Merkle 路径来计量——这正是为什么用 Bitcoin Script 编写的验证器几乎把全部预算都花在哈希上。格 PCS 则直接证明恒等式,其代价以环乘法次数和范数增长来计量。两者是代价重心不同的不同机制;用一个替换另一个,改变的是系统的代价结构,而不是一个参数。
组合。#
Greyhound 的贡献在于图 28.5 中带有格所要求的范数控制的三轮协议,然后是一次组合:该图的检查 1–5 是关于短向量 \(\mathbf{d}\) 和 \(\mathbf{z}\) 的线性和二次关系,也就是第 28.9.5 节意义上的点积约束系统,因此 LaBRADOR 可以证明存在一个满足条件的转录本,并把 \(O(\sqrt{N})\) 的转录本压缩到多对数大小 [32]。
这种组合只影响证明尺寸。亚线性验证者在基础协议中就已经存在;LaBRADOR 缩小了证明,而验证者的代价保持不变,仍为 \(O(\sqrt{N})\)。
验证者实际计算的内容#
验证常常被概括为借助 NTT 的环乘法;实际实现没有那么直接。证明模数是为了让安全性论证成立而选取的,而不是为了对 NTT 友好,Greyhound 的模数就不是 NTT 友好的:其实现明确指出,基于 NTT 的乘法不能直接用于 \(R_q\),而是改为在若干个 12 到 14 位的、确实在 \(\mathbb{Z}[X]/(X^{64}+1)\) 中完全分裂的小素数下做乘法,再通过显式的 CRT 重组 [32]。
第 6 章的变换仍然会运行,但每次乘法要运行多次,随后还要进行一次 CRT 重构。对于按操作计费的验证者而言,这个常数因子是设计的一部分。
证明尺寸与验证代价。#
格论证以很大的优势产生最小的后量子证明:LaBRADOR 在 128 位安全级别下用 58 kB 证明一个含 \(2^{20}\) 条约束的 R1CS,而基于哈希的家族需要数兆字节。代价并未消失,而是转移了,转移到了验证者身上——LaBRADOR 的验证者与见证呈线性关系,而 Greyhound 测得验证一个次数为 \(2^{30}\) 的求值需要 2.80 s,其作者自己估计约为 Ligero 的两倍 [32]。位于合约或脚本内部的验证者是在用时间换字节,应当确认自己确实想要这种交换。
这一方向上已发表的数字也需要仔细解读,因为没有任何两个数字测量的是同一个对象:Greyhound 的标题数字 53 kB 是一个求值证明,而不是对一个计算的证明;而被广泛引用的 SALSAA 的 73 kB 是在线性关系上的一步折叠,同一系统的通用论证则为 979 kB [33]。
签名聚合。#
没有任何已标准化的后量子签名能够聚合(第 28.9.1 节);只存在一项研究结果。Falcon 签名可以通过在 LaBRADOR 中证明其验证过程来聚合:500 个签名约为 73 kB,而其他最好的格聚合签名方案约为 3.6 MB [31]。这里有两点限定。参数处于 121 位安全级别而非 128 位,而且所有尺寸都是解析估计——没有可供测量的证明者或验证者实现。
这一机制也说明了为什么即便聚合可行,它也不是免费的。除了上文提到的精确短性修复之外,该证明根本无法在 Falcon 自身的模数上运行:论证所用的投影需要 \(q=12289\) 所不具备的空间,因此语句被提升到一个证明模数上,对 FN-DSA-512 为 61 位,对 FN-DSA-1024 为 63 位 [31]。聚合签名意味着用一种与签名时不同的算术来证明关于它们的语句。
第三点限定涉及通用性。该结果不能迁移到 ML-DSA,原因是结构性的:其可靠性证明只针对先哈希后签名方案(即第 18 章的 GPV 结构)处理了签名预言机,而 ML-DSA 的 Fiat–Shamir-with-aborts 结构(第 17 章)恰恰是该证明无法容纳的。因此,现有唯一的聚合结果适用于 FN-DSA 而不适用于 ML-DSA,这为第 28.4.4 节的比较增添了尺寸之外的一项考量。
格家族内部的假设。#
在这里,家族标签所能决定的东西,和在第 28.9.1 节中一样少。2024 年,有人给出了一个量子多项式时间算法,它能够采样出分布良好的 LWE 实例,同时可证明地不知道秘密,所需的假设只是 LWE 是困难的 [34]。它一举使六个已发表的格 SNARK 的安全性分析失效。
该结果的适用范围很有启发性。受影响的六个方案都是标准模型下的指定验证者构造,依赖于一个编码知识(knowledge-of-encoding)假设——而该采样器恰好驳倒了这一假设。LaBRADOR 一脉则不受影响,因为它在随机预言机模型中假设 Module-SIS,从不假设产生了某个编码的敌手必然知道它所编码的内容。这两条路线共享同一个原语家族,却依赖于不同的假设,结果也不同;论文明确指出,它使安全性分析失效,而不是攻破了这些构造。在技术栈的每一个层次上,决定安全性的都是假设,而不是家族标签。
28.10时间表与真实的不确定性#
截至 2026 年年中,尚不存在能够攻破 secp256k1 或 BLS12-381 的量子计算机。2026 年的一篇 arXiv 预印本(并非共识性综述)给出了一组依赖于模型的、关于密码学相关量子计算的估计 [1]。Google 2025 年对 RSA-2048 的一项分析展示了资源估计的下降趋势,但它专门针对 RSA,并不是对 Bitcoin 或 Ethereum 所用曲线的直接估计 [35]。专家意见征询 [36]和各国指南 [37–39]将常规系统的迁移截止期限定在 2030 年代早期到中期。NIST 将在 2030 年后弃用所有量子脆弱的公钥算法,并在 2035 年后禁止使用,无论密钥长度如何 [37];美国联邦最敏感的系统必须在 2030 年底前采用后量子密钥建立,在 2031 年底前采用后量子签名 [40, 41]。但这些目标是为企业 IT 设定的,在那里管理员可以部署变更;它们并没有针对一个需要每位用户各自采取行动的系统进行校准。
真实的立场是:Mosca 不等式中的 \(z\) 是未知的,并且存在争议。有用的回应是停止争论 \(z\),转而测量 \(y\)——迁移时间是系统的属性,而不是敌手的属性,而且与 \(z\) 不同,它是可以计算的。
28.10.1迁移受区块空间的限制#
这是路线图争论往往略过的约束。迁移一枚币不是一次数据库更新;它是一笔交易,而交易要争夺固定且相当小的区块空间。因此,任何迁移可能的推进速度都有一个下限,而它只取决于算术——需要移动的输出数量、一次后量子花费的尺寸,以及链的吞吐量。
记 \(N\) 为需要迁移的未花费输出数量,\(w\) 为单笔迁移交易消耗的权重,\(W\) 为每个区块可用的权重,\(T\) 为出块间隔。即使把每个区块的每一个单位都交给迁移,仍然需要 \[T_{\min} \;=\; T \cdot \left\lceil \frac{N\,w}{W} \right\rceil ,\] 而在区块空间份额为 \(\sigma\) 时,这个数字按 \(1/\sigma\) 放大。
这个界有两个特点值得强调。它是一个下界,假设链的全部容量都用于迁移而别无他用——没有支付,没有普通的经济活动——这是任何运行中的链都无法容忍的。而且它由 \(w\) 驱动,而对于后量子花费,这一项由签名和公钥主导,而这恰恰是比其所替换者大一到两个数量级的量。本书通篇列出的尺寸不仅仅是带宽上的麻烦:它们决定了迁移本身的时钟。
一项已发表的针对 Bitcoin 的此类分析报告称,在其关于哪些输出必须移动以及一次迁移花费代价的自身假设下,所需的停机时间约为数月的独占区块空间 [42]。下面的练习构建了一个更粗糙的模型,并得到了一个更大的结果;这种差异正是有启发性的部分,而调和两者正是目的所在。
注 1.5 (为何这重塑了整章的框架). 本章中其他每一个量都存在争议:Q-Day 何时到来,冻结是否正当,哪种签名方案胜出。吞吐量界则不然。它由区块大小、签名尺寸和算术推出,它表明,即使是一个协调完美、意见完全一致、钱包支持即时到位的生态系统,也无法迅速完成迁移。这是支持尽早开始的最有力论据,而且它不需要在任何关于量子硬件的争论中获胜。
练习:计算这个界#
公式对 \(w\) 的敏感性最好通过求值来体会。使用第 2 章的工具:
# Lower bound on migration time: every weight unit of every block, nothing else.
BLOCK_WEIGHT   = 4_000_000   # weight units available per Bitcoin block
BLOCKS_PER_DAY = 144         # one block per ten minutes

def migration_days(n_outputs, witness_bytes, base_bytes=80, share=1.0):
    # SegWit discount: witness bytes cost 1 weight unit, the rest cost 4.
    weight_per_tx = witness_bytes + 4 * base_bytes
    per_block = BLOCK_WEIGHT // weight_per_tx
    blocks = -(-n_outputs // per_block)          # ceiling division
    return blocks / (BLOCKS_PER_DAY * share)

SCHEMES = [("ed25519 (baseline)",  64 + 32),      # signature + public key
           ("FN-DSA-512",         666 +  897),
           ("FN-DSA-1024",       1280 + 1793),
           ("ML-DSA-65",         3309 + 1952),
           ("SLH-DSA-128s",      7856 + 32)]

for label, n in [("every UTXO (~190M)", 190_000_000),
                 ("exposed third (~63M)", 63_000_000)]:
    print(label)
    for name, size in SCHEMES:
        print(f"  {name:20s} {migration_days(n, size):8.0f} days exclusive"
              f"   {migration_days(n, size, share=0.10):8.0f} days at 10%")
该模型给出:在独占全链的情况下,以 ML-DSA-65 的尺寸移动所有输出大约需要 1800 天,仅移动已暴露的三分之一约需 600 天——而经典基线分别为 137 天和 46 天。若只占用十分之一的区块空间(对于一条必须继续处理支付的链来说,这已经很慷慨了),仅已暴露的三分之一就需要约十六年。
从中可以得出四点。基线各行表明,即使使用经典签名,迁移也很慢,因此后量子尺寸是一个加重因素,而不是唯一原因。SLH-DSA 各行用时间表而不是字节来为最保守的假设定价——第 27 章的尺寸表陈述了这种权衡,但没有计算其代价。FN-DSA 各行正是第 28.4.4 节关注合计占用的原因:在 Falcon-512 的尺寸下,时间表大约是 ML-DSA-65 数字的三分之一、SLH-DSA 数字的五分之一,因此方案的选择会把迁移时钟移动若干年,而不是若干百分比。而这些数字与已发表估计之间的差距本身就是教训:本模型每笔交易迁移一个输出,按完整见证尺寸计算,并针对整个已暴露集合。其中每一项都是悲观的,而已发表的分析放宽了它们。
那就放宽它们,看看哪一项起作用。改变需要迁移的集合;把许多输出批处理到一笔交易中;用聚合或基于证明的授权来代替每个输出一个签名。批处理是值得关注的杠杆,因为 \(N\) 和 \(W\) 对设计者来说是给定的,而每个被迁移输出的 \(w\) 是协议真正能够协商的唯一一项——这恰恰是本章中的输出类型提案和恢复路径提案试图争取的东西。
注 1.6 (请勿引用这个数字). 上述数字取决于 UTXO 数量、被视为已暴露的比例、见证折扣、批处理以及所用方案——本章的误区 3 对它们的适用程度不亚于对 gas 数字的适用程度。在这些不确定性之下仍然成立的结论是数量级:在任何能让链保持可用的假设组合下,都是以年计,而非以周计。
28.11常见陷阱#
陷阱 1:认为“我的地址是一个哈希,所以我是安全的”。#
这只在首次花费之前成立。任何进行过交易的账户都已暴露了其公钥;在 Ethereum 上,这基本上就是每一个活跃账户,而在 Bitcoin 上,这包括每一个被重用的地址。
陷阱 2:把草案提案当作已有定论。#
BIP-360、BIP-361 和 EIP-8141 都是草案;尤其是冻结问题存在争议。把它们报道为 Bitcoin 或 Ethereum 的“计划”,会夸大共识程度。
陷阱 3:引用单个 gas 数字。#
链上验证成本会随实现、版本和预编译合约假设而变化。一个没有出处和日期的数字是没有意义的。
陷阱 4:认为混合签名是安全的默认选择。#
在 TLS 中它们是保守的选择,因为那里的冗余工作是临时的、可协商的、不可见的(第 27.3.2 节)。而在链上,额外的签名由所有人永久存储,无法被协商掉,并且迫使用户迁移两次。在这里照搬互联网的默认做法,会使主导成本翻倍。
陷阱 5:引用暴露百分比而不说明其成因。#
“供应量的三分之一已暴露”这种说法,把按设计公布密钥的输出与被重用的地址混为一谈,而只有后者仍在增长,并且无需共识变更即可减少(第 28.4.2 节)。
陷阱 6:把迁移当作一个排期问题。#
它是一个吞吐量问题。无论生态系统协调得多好,区块空间都从下方为它设定了界(第 28.10.1 节),因此一个在 Q-Day 宣布时才开始的计划无法完成,无论届时每个人的积极性有多高。
28.12小结#
区块链使量子威胁更加尖锐,也使应对更加复杂:
危险在于签名(Shor),而不在于哈希(Grover);不可篡改账本上的已暴露公钥是一项永久的、“先存储、后盗取”的负债——这使 Mosca 不等式中的保密期项无界,因此对任何有限的 Q-Day,\(x+y>z\) 都成立,唯一的出路是消除暴露;
暴露有两种成因,补救办法各不相同:按设计公布密钥的输出类型,以及地址重用——后者份额更大,仍在累积,而且仅靠钱包行为就能减少;
管理密钥(稳定币的代理管理员、铸币者、暂停者)是集中的情形:密钥少,影响范围由众人共担,多签和硬件托管对其无效,但其所有者是真正能够采取行动的一方;
Bitcoin 提出了一种新的抗量子输出类型(BIP-360)和一项有争议的遗留签名停用方案(BIP-361),两者都是草案状态的软分叉;
Ethereum 将一个带有基于 STARK 的哈希原像恢复的紧急硬分叉,与一条账户抽象迁移路径(EIP-7702 已上线,EIP-8141 为草案)结合起来,目标是在 2028–2029 年窗口内实现第一层的后量子基础设施;
Cosmos 在已发布代码方面走得最远,已将 ML-DSA-65 注册为可选启用的验证者共识密钥类型,其密钥尺寸为 ed25519 的 \(60\times\),签名尺寸为其 \(50\times\);
二层网络同时继承了所有这些问题,却只能修复其中一部分,因此它的计划必须按每个攻击面的所有权而不是按方案来组织;
对称层或基于哈希的层只保护它所承载的东西:Winternitz 承诺、混淆电路和 FRI 承诺都曾被发现包裹着椭圆曲线断言,而证明系统可能把对离散对数的依赖隐藏在一个并非其标志性承诺方案的论证之中;
有些暴露根本无法迁移——EVM 配对预编译合约的调用者不可变,因此只能清点、永远无法升级——而且聚合没有后量子的直接替代品,这就是为什么替换 BLS 是一项架构工程;
EdDSA 链从 RFC 8032 “先种子、后哈希”的密钥生成中继承了一条恢复路径,使所有者可以在 Q-Day 之后、无需任何事先行动即可证明对种子的知识;ECDSA 链可以按钱包逐一模仿这一点(BIP-32 已经这样做了),但无法使之成为共识规则,因为这种结构既不普遍,也无法在链上检测;
迁移从下方受区块空间而非意愿的限制:在后量子见证尺寸下,下限是数月到数年的独占区块空间,而在任何能让链保持可用的份额下则是数年到数十年——这个界来自算术,而不是来自任何关于量子硬件的有争议的论断;
时间表并不确定,但所需的准备时间很长,这就是为什么这些社区在任何量子计算机能够实施攻击的多年之前,就已在争论这一过渡。
这里是密码学理论与部署中最棘手的现实——不可篡改的历史、去中心化的治理以及不可逆转的损失——相遇之处,也是一个合适的收尾之处:数学已经就绪,而迁移依赖于它的那些系统这一更艰难的工作才刚刚开始。
参考文献
feat/lthash. https://github.com/ProjectZKM/Ziren/issues/276
评论