第 22 章Classic McEliece
22.1学习目标#
到目前为止,本书借助了两类困难问题:格(ML-KEM、ML-DSA、FN-DSA)和哈希函数(SLH-DSA)。本部分开启第三个完全独立的基础。基于编码的密码并不要求你在格中寻找短向量;它要求你对一个看似随机的线性码进行译码。它是所有后量子密码族中最古老的一支——Robert McEliece 于 1978 年提出了他的方案,与 RSA 问世同年 [1]——在经受了四十多年的攻击之后,它基本上仍未被攻破。正是这一记录使它备受珍视:格标准以牺牲少许保守性换取小密钥和高速度,而 Classic McEliece 押下的是相反的赌注。
读完本章后,你应当能够:
陈述二元线性码的基本对象——生成矩阵、校验矩阵、Hamming 重量与 Hamming 距离,以及错误的校验子;
解释校验子译码问题,以及为何它的 NP 困难性(除 Grover 之外没有已知的量子捷径)是该方案的安全基础;
描述陷门:一个能够被高效译码的秘密码,被伪装成一个无法被译码的码;
理解 KeyGen、Encapsulate 和 Decapsulate 算法,并准确看出秘密译码器在何处被使用;
解释 Classic McEliece 所作的权衡——以非常大的公钥换取极小的密文和一段长久而保守的安全记录。
本章为何重要。#
基于编码的密码是量子威胁一章(第 1 章)中与格和哈希并列提到的三类问题之一。每一类都是针对不确定的量子未来所下的一个不同赌注,而同时持有多个赌注的价值在于它们会相互独立地失效:针对格的突破对编码毫无影响。Classic McEliece 是基于编码的对冲手段中的旗舰。理解它也使我们对“后量子”含义的认识趋于完整——它不是单一的思想,而是若干互不相关的困难问题,其中任何一个都可以支撑公钥密码度过量子时代。
22.2线性码速成#
读者已经接触过格和多项式环,但迄今尚未接触编码理论。本节构建该方案所需的少数几个对象。一切都定义在二元域 \(\mathbb{F}_2 = \{0,1\}\) 之上,其中加法就是异或(XOR)。
作为子空间的码。#
一个二元线性码 \(C\) 不过是 \(\mathbb{F}_2^n\) 的一个线性子空间。若该子空间的维数为 \(k\),我们称 \(C\) 为一个 \([n,k]\) 码:它包含 \(2^k\) 个码字,每个码字是一个 \(n\) 比特串。其思想是冗余。我们取一条 \(k\) 比特消息,将其展开到 \(n > k\) 个比特上,这样即使其中少数几个比特在传输中被翻转,我们仍能恢复原始消息。
生成矩阵。#
由于 \(C\) 是一个 \(k\) 维子空间,它有一组由 \(k\) 个码字构成的基。把这组基作为一个 \(k \times n\) 矩阵 \(G\) 的各行堆叠起来,就得到生成矩阵。于是对消息 \(m \in \mathbb{F}_2^k\) 的编码就是一次矩阵乘法: \[c = m\,G \in \mathbb{F}_2^n .\] 当 \(m\) 取遍全部 \(2^k\) 条消息时,\(mG\) 便取遍所有码字。生成矩阵就是写下来的码本身。
校验矩阵。#
同一个子空间也可以从外部来描述,即通过其码字所满足的线性约束。校验矩阵 \(H\) 是一个 \((n-k) \times n\) 矩阵,其零空间恰好是 \(C\): \[H\,c^\top = 0 \quad\text{for every codeword } c \in C .\] 因此,\(G\) 告诉你如何构造码字,而 \(H\) 告诉你如何识别码字。二者通过 \(G H^\top = 0\) 相联系。
重量、距离与纠错。#
一个向量的 Hamming 重量 \(\mathrm{wt}(x)\) 是其非零坐标的个数,两个向量之间的 Hamming 距离是它们之差的重量,即 \(d(x,y) = \mathrm{wt}(x-y)\)。一个码的最小距离 \(d\) 是两个不同码字之间的最小距离。最小距离为 \(d\) 的码可以纠正至多 \[t = \left\lfloor \tfrac{d-1}{2} \right\rfloor\] 个比特错误:如果一个码字至多在 \(t\) 个位置上被破坏,它与原码字的距离仍然比与任何其他码字的距离更近,因此原码字在原理上可以被恢复。
校验子。#
假设发送了码字 \(c\),而接收到的是 \(y = c + e\),其中 \(e\) 是一个未知的错误向量。将接收字与校验矩阵相乘得到 \[s = H\,y^\top = H\,c^\top + H\,e^\top = H\,e^\top ,\] 因为 \(Hc^\top = 0\)。所得结果 \(s \in \mathbb{F}_2^{\,n-k}\) 就是校验子(syndrome)。有两点值得停下来体会。第一,校验子只依赖于错误,而与发送的是哪个码字无关。第二,译码——恢复 \(e\)(从而恢复 \(c\))——恰恰就是寻找一个能产生所观测到的校验子的低重量 \(e\)。这一个观察就是整章的枢纽。
22.3困难问题:校验子译码#
对于一个具有有用结构的码,译码是容易的——这正是设计码的全部意义所在。但一旦剥去结构,情形就反转了。
校验子译码。给定一个随机校验矩阵 \(H \in \mathbb{F}_2^{(n-k)\times n}\)、一个目标校验子 \(s \in \mathbb{F}_2^{\,n-k}\) 和一个重量 \(t\),求一个满足 \(\mathrm{wt}(e) \le t\) 且 \(H\,e^\top = s\) 的错误向量 \(e\)。
对于一个没有可利用结构的码,这确实是困难的。Berlekamp、McEliece 和 van Tilborg 于 1978 年证明了它是 NP 完全的 [2]——与该加密方案的提出同年。直观地说,线性方程组 \(He^\top = s\) 有许多解,但几乎所有解的重量都很大;约束 \(\mathrm{wt}(e) \le t\) 挑出的是一根指数级稀有的针,而且没有任何线性代数的捷径可以找到它。
已知最好的攻击是信息集译码(information-set decoding,ISD)算法族,自 20 世纪 60 年代以来一直在稳步改进。它们的运行时间是码参数的指数函数,几十年的优化只改进了指数中的常数,从未消除指数。关键在于,量子计算机并不会在性质上改变这一图景:最强的量子变体在 ISD 内部应用 Grover 式搜索,至多获得平方根级的加速,这恰恰是量子威胁一章所描述的、所有后量子密码族都会遭受的轻微侵蚀。不存在类似 Shor 算法的崩溃。把参数加倍即可恢复失去的余量,正如对对称密码所做的那样。
这就是安全基础。如果我们能够向攻击者呈现一个看似随机的校验矩阵和一个校验子,而秘密是一个低重量的错误,那么攻破该方案就意味着求解校验子译码问题。
22.4陷门:一个伪装起来的可译码码#
当然,问题在于诚实的参与方同样只能看到公开矩阵。如果它真的是随机的,谁都无法译码,该方案也就毫无用处。解决办法是陷门密码学的核心技巧:从一个确实具有高效译码器的码出发,然后把它伪装得如此彻底,以至于从外部看它与随机码无法区分。
秘密码。#
Classic McEliece 用一个二元 Goppa 码构建其秘密。这类码的完整构造、参数和译码在附录 A 中展开;这里我们所依赖的两条性质可以简单陈述如下:
它是一个 \([n,k]\) 线性码,具有生成矩阵 \(G\),其选取使之能够纠正 \(t\) 个错误;
它配有一个高效的 \(t\) 错误译码算法 \(\mathcal{D}_g\)(Patterson 算法),该算法接受任何与某个码字距离不超过 \(t\) 的字,并返回该码字和错误。
Goppa 码在这里担当主力有一个特定的原因:经过四十年的审视,被打乱的 Goppa 码仍然无法通过任何已知的高效检验与随机线性码区分开来。其他看起来同样有前途的码族(例如某些代数码)后来被证明会泄露其结构,并被攻破。Goppa 码则经受住了考验。
伪装。#
两个秘密成分隐藏了结构:
一个 \(\mathbb{F}_2\) 上 \(k \times k\) 的随机可逆扰乱矩阵 \(S\),它混合 \(G\) 的各行(它改变的是基,而不是码);
一个随机的 \(n \times n\) 置换矩阵 \(P\),它打乱坐标的次序。
公钥是变换后的生成矩阵 \[G' = S\,G\,P .\] 用 \(S\) 扰乱和用 \(P\) 置换都保持了“这是某个 \([n,k]\) 码”这一事实,但它们摧毁了使 \(G\) 可译码的 Goppa 结构的一切可见痕迹。对于任何不掌握 \(S\)、\(P\) 和 \(\mathcal{D}_g\) 的人来说,矩阵 \(G'\) 只是一个看似随机、没有已知高效译码器的码。
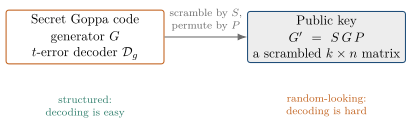
图注中的不对称性用一句话概括了整个方案。加密是在一个公开码字上加一个重量为 \(t\) 的错误;这对任何人都很容易。解密则是去除该错误;这只对陷门持有者是容易的,而对其他所有人来说,就是校验子译码问题。
22.5方案#
我们给出同一思想的两种视角。最初的 1978 年形式直接加密消息,是对陷门最清晰的说明。现代形式——即 NIST “Classic McEliece” 提交方案 [3] 实际规定的形式——是一个建立在码的对偶描述(即校验矩阵描述)之上的密钥封装机制(KEM)。两者依赖于同一个秘密译码器。
22.5.1最初的 1978 年加密方案#
密钥生成产生上一节所述的伪装:一个带有译码器 \(\mathcal{D}_g\) 的秘密 Goppa 码、一个扰乱矩阵 \(S\)、一个置换 \(P\),以及公开生成矩阵 \(G' = SGP\)。
为了加密消息 \(m \in \mathbb{F}_2^k\),发送者针对公开矩阵对其编码,并有意加上一个重量恰为 \(t\) 的新鲜随机错误 \(e\): \[c = m\,G' + e , \qquad \mathrm{wt}(e) = t .\] 密文 \(c\) 是公开码的一个码字在 \(t\) 个位置上被撞离码之后的结果。对窃听者而言,恢复 \(m\) 意味着去除 \(e\)——即对一个看似随机的码进行校验子译码。
为了解密,接收者一层一层地剥去伪装,而秘密正是在这里被使用的。关键的代数事实是:置换只是重新排列错误的位置,因而永远不会改变其重量。
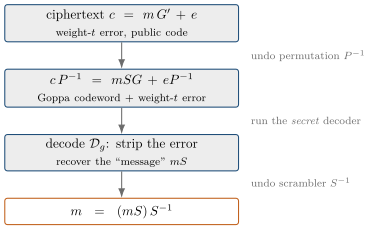
写出来,解密过程就是:计算 \(cP^{-1} = mSG + eP^{-1}\),它是一个恰在 \(t\) 个位置上被破坏的 Goppa 码字 \(mSG\);运行 \(\mathcal{D}_g\) 去除错误并读出 \(mS\);然后乘以 \(S^{-1}\) 得到 \(m\)。没有秘密译码器,第二步就无法完成,而这就是该方案的全部安全性所在。
22.5.2现代 KEM:发送一个校验子#
NIST 提交方案使用 Niederreiter 表示形式 [4],它是上述图景的对偶。它不公开被扰乱的生成矩阵,而是公开被扰乱的校验矩阵;它也不加密一条选定的消息,而是封装一个随机密钥。这种形式的密文更小,也是今天你应当理解为“Classic McEliece”的那个方案。
现在公钥是一个被伪装的校验矩阵 \[H' = S\,H\,P ,\] 其中 \(H\) 是秘密 Goppa 码的校验矩阵,\(S\) 是一个 \((n-k)\times(n-k)\) 的可逆扰乱矩阵,\(P\) 仍是一个坐标置换。(在实际规范中,\(H'\) 被约化为系统形式 \([\,I \mid T\,]\),因此只需存储子块 \(T\);扰乱矩阵 \(S\) 恰好就是实现这一约化的行变换。为清楚起见,我们在这里把 \(S\) 显式写出。)
封装的思想是:秘密是一个低重量的错误向量,而密文是它的校验子。由于在一个看似随机的 \(H'\) 下,重量为 \(t\) 的错误的校验子难以求逆,密文便对除陷门持有者以外的所有人隐藏了该错误。共享密钥随后通过对该错误求哈希而派生。
封装从不触及秘密。它只是采样一个具有规定重量的随机错误,并给出其校验子。
解封装是陷门被使用的地方。接收者撤销扰乱,把结果交给秘密 Goppa 译码器以恢复一个经过置换的错误,然后撤销置换并重新求哈希——得到与发送者计算的相同的密钥。
正确性与图 22.2 互为镜像:乘以 \(S^{-1}\) 把公开密文 \(c = SHP\,e^\top\) 变为 \(H(Pe^\top)\),即 Goppa 码对一个经过置换但重量不变的错误的真正校验子;由于该错误的重量恰为 \(t\),译码器 \(\mathcal{D}_g\) 能够恢复它;撤销 \(P\) 便还原出原始的 \(e\);对 \(e\) 求哈希则重现发送者的密钥。只看到 \(H'\) 和 \(c\) 的攻击者则只能面对校验子译码问题。
关于实际加固的说明。#
上面的教学形式令 \(K = \mathrm{Hash}(e)\)。为了获得针对主动(选择密文)攻击者的安全性,实际规范还把密文一并哈希进密钥,并使用隐式拒绝:如果译码失败或恢复出的错误重量不对,解封装不会中止,而是返回一个由存储在密钥中的秘密派生出的伪随机密钥。这向攻击者隐藏了译码是否成功,从而堵住了一类反应攻击。其本质结构——输入错误、输出校验子、用陷门译码——与上文所示完全一致。
22.6权衡与现状#
Classic McEliece 作出了一个不寻常且经过深思熟虑的取舍。它的公钥极其庞大——一个数百 KB 的稠密矩阵,在最高安全级别下可达约 1 MB——因为公钥本质上就是一个看似随机的码,没有任何种子可以把它压缩下来(与之对照,在格标准中,公开矩阵可以由一个 32 字节的种子重新生成)。但其他一切都既小又快:密文仅仅是一个校验子,远小于几百字节,封装和解封装也都很快。格 KEM 在各项尺寸之间取得平衡,而 Classic McEliece 则把全部代价都压到一个一次性生成、可以长期重用的静态公钥上。
| 方案 | 公钥 | 密文 | 困难性假设 |
|---|---|---|---|
Classic McEliece 348864 |
\(\approx 261\) KB | \(96\) B | 校验子译码(编码) |
Classic McEliece 6960119 |
\(\approx 1.0\) MB | \(194\) B | 校验子译码(编码) |
| ML-KEM-768 | \(1184\) B | \(1088\) B | 模 LWE(格) |
现状。#
Classic McEliece 作为密钥封装候选方案参加了 NIST 后量子项目,并进入了专门针对额外 KEM 的第四轮。它并不是已发布的 NIST FIPS,而且 NIST IR 8545 为额外 KEM 的标准化路径选择了 HQC 而非 Classic McEliece。尽管如此,Classic McEliece 拥有本书所有方案中最长的公开密码分析记录,而这一记录正是它值得研究的原因。
这一记录目前正在变化。#
自 2023 年以来,一系列结构性攻击正在逼近这些参数集本身。它们都没有解密任何东西,也都没有在标准化参数下恢复密钥;它们攻击的是公钥与随机矩阵之间的不可区分性。其中最新的一项来自 Ghoshal、Ishai、Jain 和 Sun [5],它是拟多项式时间的,适用于 NIST 考虑过的每一个参数集,并且——在最小的参数集上——所需的运算次数少于通用译码。附录 A 详细讨论了它是如何做到这一点的,以及它留下了哪些未被撼动的部分,因为其机制的启发意义远远超出了这一个方案。
诚实的总结分为两部分,而这两部分很容易被混为一谈:
最小假设——恢复消息意味着译码,而译码是困难的——完好无损,没有任何攻击接近它;
保守假设——公钥与随机矩阵不可区分,这正是人们称 McEliece 为稳妥之选时通常援引的那个假设——在任何标准化参数集上都不再成立。
决定是否部署该方案的读者应当权衡这两点。决定是否研究它的读者则应当注意到,一个已有四十八年历史的方案目前是该领域最有意思的密码分析目标,这并不构成不读本章的理由。
22.7常见陷阱#
陷阱 1:以为庞大的公钥是一个有待修复的缺陷。#
这一尺寸是内在的。公钥是一个看似随机的码,而随机码没有比矩阵本身更短的描述。你无法像 ML-KEM 重新生成其矩阵 \(A\) 那样由一个小种子重新生成它,因为可由种子扩展得到的矩阵会带有可被利用的结构。庞大的密钥是保守假设的代价,而不是实现上的疏忽。
陷阱 2:以为错误重量可以商量。#
译码器 \(\mathcal{D}_g\) 能纠正至多 \(t\) 个错误,不能更多。封装必须使用重量恰为 \(t\) 的错误:太少则更容易被攻击,太多则诚实的译码会失败。重量是一个固定的方案参数,而不是在加密时可以调节的旋钮。
陷阱 3:以为任何可译码的码族都可以。#
安全性依赖于被打乱的码与随机码不可区分。若干提供高效译码器的码族(例如某些代数码和低密度码)已被证明会透过伪装泄露其结构,并被彻底攻破。之所以使用二元 Goppa 码,是因为它们抵御住了那些攻击——而正如第 A.8 节所阐述的,它们现在也会泄露这种结构,只是代价是拟多项式的而非多项式的。“不泄露任何东西”与“以高昂代价泄露”之间的区别就是该方案目前的全部余量,因此值得把它分辨清楚。
陷阱 4:跳过选择密文加固。#
算法框中的裸方案只具有被动安全性。实际部署必须把密文绑定到密钥中并使用隐式拒绝,正如格 KEM 应用 Fujisaki–Okamoto 式变换那样(第 16.13 节)。省略这一点会暴露于反应攻击之下,攻击者可以根据译码是否成功来获知秘密。
22.8小结#
基于编码的密码依赖于一个与格完全无关的困难问题:对随机线性码译码,形式化为校验子译码问题,它是 NP 困难的,并且除了 Grover 算法带来的轻微平方根级侵蚀之外,没有任何量子捷径。Classic McEliece 通过经典的陷门手法把它变成一个密码系统:
它从一个二元 Goppa 码出发,该码具有高效的 \(t\) 错误译码器 \(\mathcal{D}_g\);
它用秘密的扰乱矩阵 \(S\) 和置换 \(P\) 伪装该码,公开看起来随机的 \(G' = SGP\)(或对偶地,\(H' = SHP\));
任何人都可以封装——加上或发送一个重量为 \(t\) 的错误——但只有掌握 \(S\)、\(P\) 和 \(\mathcal{D}_g\) 的人才能解封装,因为只有他们能够译码;
它以非常大的公钥为代价,换来了异常强的保守性——四十八年来没有出现解密攻击或密钥恢复攻击——同时保持密文极小。
最后这一论断需要把它的限定条件明确说出来,而不是默认。从未被攻破的是译码的困难性。已被攻破的——在本书第一版本应写成的时间之后——是公钥与随机矩阵不可区分这一论断:一个拟多项式区分器现已覆盖每一个参数集(第 A.8 节)。该方案的运行方式没有任何改变;改变的是这两个假设中你有权倚靠的是哪一个。
机制之外的教训是:“后量子”并非单一的思想,而是由相互独立的赌注构成的组合。Classic McEliece 是基于编码的密码族中最古老、最谨慎的成员,即伪装成随机码的译码问题。下一章关于 HQC,它在同一片基于编码的领域中走了一条不同的路线:它不隐藏一个强结构化的 Goppa 码,而是把安全性建立在对准循环码译码的困难性之上,以远为紧凑的密钥取代 Classic McEliece 的巨型密钥——并因此成为 NIST 选择进行标准化的基于编码的方案。
评论