第 14 章Kyber(ML-KEM)入门
14.1什么是 Kyber?#
Kyber——由 NIST 在 FIPS 203 中标准化为 ML-KEM [1, 2]——是当今保护互联网大部分通信的密钥交换的后量子替代方案。它是一种密钥封装机制(KEM):双方借此在公开信道上建立共享秘密的协议,扮演的正是 Diffie–Hellman 和 RSA 密钥传输在前量子时代所扮演的角色。其困难性建立在模 LWE(第 13 章)之上,即前几章所展开的 LWE 家族中的中间成员。
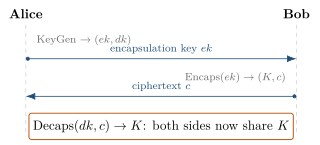
一个 KEM 由三个算法定义:
KeyGen \(\to (ek, dk)\)——生成一个公开的封装密钥 \(ek\) 和一个秘密的解封装密钥 \(dk\);
Encaps\((ek)\,\to (K, c)\)——生成一个新的共享秘密 \(K\),以及承载它的密文 \(c\);
Decaps\((dk, c)\,\to K\)——从密文中恢复出同一个共享秘密 \(K\)。
关键在于,KEM 传输的是一个随机秘密,而不是一条选定的消息。正是这一个设计选择,使得后续的 Fujisaki–Okamoto 变换能够把 Kyber 提升到抵抗主动的选择密文攻击者的安全性。
14.2各个组件,以及本书在何处构建它们#
Kyber 并不是一个新的原语。它是对本书各处所展开的组件的精心组装,而本章是这些组件首次汇聚之处——以缩微的形式。有些组件已经在手(模 LWE 关系、环、NTT);下面的玩具版仍对其余组件走了捷径,所引用的章节会完整地提供它们。
| 组成部分 | 在 Kyber 中的作用 | 构建于 |
|---|---|---|
| 模 LWE 关系 \(\mathbf{t}=A\mathbf{s}+\mathbf{e}\) | 底层困难问题 | 第 13 章 |
| 环 \(R_q=\mathbb{Z}_q[x]/(x^n+1)\) 与 NTT | 快速多项式运算 | 第 12、6 章 |
| 中心二项噪声(CBD) | 采样小的秘密/误差 | 第 15 章 |
| Fujisaki–Okamoto 变换 | 将 CPA 安全性提升为 CCA 安全性 | 第 16 章 |
| 完整的 FIPS 203 流程 | KeyGen / Encaps / Decaps \(+\) FO | 第 16 章 |
三个标准化参数集 ML-KEM-512、ML-KEM-768 和 ML-KEM-1024 共用同一个环,但使用不同的参数元组:分别为 \(k=2,3,4\),\(\eta_1=3,2,2\),以及 \((d_u,d_v)=(10,4),(10,4),(11,5)\) [1]。NIST 推荐 ML-KEM-768 作为默认参数集 [3];本章只保留一个精简的代数骨架。
14.3构建一个玩具版 Kyber#
为了在接触具体机制之前先看清骨架,我们现在用大约一百行 SageMath 构建一个玩具版 Kyber——它小到可以手工检查每个对象。仅使用已经介绍过的数学,它就能生成公钥、加密一条消息并将其解密:
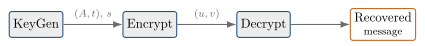
这里的目标不是重现完整的 FIPS 203 标准,而是清晰地揭示其数学骨架。所有内容都在 SageMath 中用大约一百行代码运行,从而使结构保持清晰可见。
14.4玩具版中采用的简化#
真实的 ML-KEM 标准使用了许多精巧的机制。在玩具版中,我们只保留核心思想:
| 真实 ML-KEM | 玩具版 Kyber |
|---|---|
| \(q=3329\) | \(q=17\) |
| \(n=256\) | \(n=8\) |
| CBD 噪声 | \(\text{randint}(-1,1)\) |
| SHAKE/XOF | 简单的随机生成 |
| 压缩 | 省略 |
| NTT | 普通多项式乘法 |
| FO 变换 | 省略 |
| 字节编码 | 省略 |
尽管这些简化幅度很大,数学骨架依然相同。对于模维数,我们也把 \(k\) 从 \(2,3,4\) 缩减为 \(k=2\),以便手工检查各个对象。
from random import randint

q = 17
n = 8
k = 214.5建立环#
我们定义一个模 \(x^8+1\) 的多项式环。此后构建的每个对象都位于这个商环 \(R_q\) 中。
R.<x> = PolynomialRing(GF(q))
Rq = R.quotient(x^n + 1)
a = Rq.random_element()
b = Rq.random_element()
print(a)
print(b)
print(a*b)由于商关系,最高次数应始终低于 \(8\)。
14.6构建模:多项式的向量与矩阵#
对于 Kyber512,模维数为 \(k=2\)。这意味着秘密不是一个多项式,而是由 \(k\) 个多项式组成的向量,公开矩阵 \(A\) 是一个由多项式组成的 \(k \times k\) 矩阵。
def rand_poly():
    return Rq.random_element()

def rand_vector():
    return vector(Rq, [rand_poly() for _ in range(k)])

def rand_matrix():
    return Matrix(Rq, k, k, [rand_poly() for _ in range(k*k)])
多项式向量已经是迈向模观点的第一步,而矩阵则是出现在类 Kyber 构造中的对象。
14.7生成小噪声#
在真实的 Kyber 中,噪声从中心二项分布(CBD)中采样,这是后面某一章的主题。对于玩具版,我们只使用取值于 \(\{-1,0,1\}\) 的小系数。
def small_poly():
    coeffs = []
    for _ in range(n):
        c = randint(-1, 1)
        coeffs.append(c % q)
    return Rq(coeffs)

def small_vector():
    return vector(Rq, [small_poly() for _ in range(k)])
因此多项式的系数是诸如 \(0\)、\(1\) 或 \(16\)(它在 \(\mathbb{F}_{17}\) 中表示 \(-1\))这样的小值。这会产生小的误差,适合教学使用。
14.8密钥生成#
模 LWE 形式与标准 LWE 形式非常接近: \[\mathbf{t}=A\mathbf{s}+\mathbf{e}.\]
我们按如下方式实现它。
def keygen():
    A = rand_matrix()
    s = small_vector()
    e = small_vector()
    t = A * s + e
    return (A, t), s
公钥是 \((A,t)\),秘密钥是 \(s\)。
14.9验证密钥生成过程#
我们可以打印矩阵及所得的公开值,以检查其形状和类型是否符合预期。
(pk, sk) = keygen()
A, t = pk
print("A =")
print(A)
print("\nSecret:")
print(sk)
print("\nPublic:")
print(t)
这看起来已经与 Kyber 中使用的数学对象非常接近了。
14.10编码一个消息比特#
在玩具版中,消息被简化为单个比特。在真实方案中,消息编码要微妙得多;这里我们只是把一个比特映射为零,或映射为模数范围中间附近的一个值。
def encode_bit(bit):
    if bit == 0:
        return Rq(0)
    else:
        return Rq(q // 2)
这足以演示把一个比特隐藏在带噪声线性方程中的基本思想。
14.11加密#
为了加密一个消息比特,我们采样一个随机向量 \(r\) 和两个噪声项 \(e_1,e_2\)。核心方程为 \[u = A^T r + e_1,\] \[v = t^T r + e_2 + m.\]
def encrypt(pk, bit):
    A, t = pk
    r = small_vector()
    e1 = small_vector()
    e2 = small_poly()
    u = A.transpose() * r + e1
    m = encode_bit(bit)
    v = t.dot_product(r) + e2 + m
    return (u, v)
密文是二元组 \((u,v)\)。
14.12解密#
解密步骤使用秘密钥 \(s\)。其主要思想是:在代数展开过程中,涉及 \(A\) 和 \(s\) 的项相互抵消,只留下少量噪声和编码后的消息。
def decrypt(sk, cipher):
    u, v = cipher
    value = v - sk.dot_product(u)
    return value
我们通过比较到两个编码中心 \(0\) 和 \(\lfloor q/2\rfloor\) 的循环距离来恢复比特。特别地,域元素 \(16\) 表示 \(-1\),必须被识别为接近编码后的零,而不是消息为一的值。
def recover_bit(value):
    c = value.list()[0]
    d0 = min(c, q - c)
    d1 = min((c - q//2) % q, (q//2 - c) % q)
return 0 if d0 < d1 else 114.13整合所有部分#
一次完整的玩具版运行如下所示。
# Key generation
(pk, sk) = keygen()

# Encryption
bit = 1
cipher = encrypt(pk, bit)

# Decryption
value = decrypt(sk, cipher)
print("decrypted value =", value)
print("recovered bit =", recover_bit(value))
由于噪声被刻意保持得很小,在许多次运行中它都会返回正确的比特。
14.14为什么抵消能够成立#
重要的代数思想是,公钥满足 \[\mathbf{t} = A\mathbf{s}+\mathbf{e},\] 因此在解密时计算 \[\mathbf{v} - \mathbf{s}^T\mathbf{u}.\] 展开之后,涉及 \(A\) 和 \(s\) 的项相互抵消,只留下一个小的误差项和消息。这就是类 Kyber 构造的核心。
14.15为什么该方案有时会失败#
这个玩具版构造仍然可能频繁失败,因为 \(q=17\) 非常小,而且累积误差并不像 ML-KEM 中那样受到约束。它演示的是抵消与循环译码,而不是一个可靠的加密方案。在真实的 ML-KEM 中,参数经过调校,使解密失败概率极小。
一个简单的实验是把噪声生成器从
randint(-1, 1)改为更大的范围,例如
randint(-2, 2)甚至
randint(-5, 5)并观察到解密错误变得频繁得多。这直接说明了噪声参数的作用,也预示了为什么真实的 ML-KEM 要如此仔细地控制其噪声分布。
14.16与真实 Kyber 相比还缺少什么?#
这个玩具版实现已经抓住了 ML-KEM 的数学骨架。然而,它离完整的标准仍相去甚远。以下组件尚未出现:
CBD 采样,
SHAKE128 / SHAKE256 以及基于 XOF 的扩展,
基于 NTT 的多项式乘法,
压缩与编码,
Fujisaki–Okamoto 变换,
CCA 安全性行为,
常数时间实现细节。
这些内容将在后续章节中逐步引入。
14.17小结#
这个玩具版实现以紧凑的形式抓住了 Kyber 的核心思想。从模 LWE 关系出发,密钥生成构造 \(\mathbf{t}=A\mathbf{s}+\mathbf{e}\);加密构造 \(\mathbf{u}=A^{T}\mathbf{r}+\mathbf{e}_1\) 和 \(v=\mathbf{t}^{T}\mathbf{r}+e_2+m\);解密计算 \(v-\mathbf{s}^{T}\mathbf{u}\),并从所得的小的带噪声值中恢复消息。
最重要的教训是,Kyber 并不是一个全新的原语。它是我们在全书中一直研究的同一带噪声线性结构经过精心工程化的版本。接下来的几章将替换剩余的捷径:真实的 CBD 噪声采样(第 15 章),然后是完整的 FIPS 203 实现——密钥生成、封装、解封装以及 Fujisaki–Okamoto 变换——见第 16 章。
评论