第 10 章概率与误差分布
10.1什么是分布?#
许多教材会写出这样的表达式: \[e \leftarrow \chi,\] 其中符号 \(\chi\) 是一个概率分布。用通俗的话说,这表示值 \(e\) 是从某个分布中随机抽样得到的。
例如,掷一枚骰子时,结果是下列集合中的一个: \[\{1,2,3,4,5,6\},\] 每个值以一定的概率出现。这就是一个分布。
形式化地说,分布描述了每种可能结果的概率: \[\Pr(X=x).\]
10.2均匀分布#
最简单的分布是均匀分布。例如,假设该值从下列集合中均匀选取: \[\{0,1,2,3\}.\] 那么每个元素出现的概率都是 \(1/4\)。
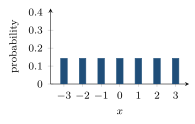
在直方图中,所有柱子的高度都相同。这是最容易理解的随机性概念,但它通常不适合用作 LWE 噪声。
如果噪声在一个很宽的范围上均匀分布,比如从 \(-100\) 到 \(100\),那么所得误差将过大,解密无法可靠地进行。简而言之,均匀噪声太“野”了。
10.3高斯分布#
许多自然现象近似服从高斯分布,例如人的身高、测量误差以及围绕均值的随机波动。高斯分布以零为中心,呈钟形。标准记法为 \[N(0,\sigma^2),\] 表示均值为 \(0\)、方差为 \(\sigma^2\)。
参数 \(\sigma\) 控制噪声的离散程度。\(\sigma\) 较小意味着大多数样本接近零;\(\sigma\) 较大意味着样本分布得更分散。
10.4为什么均值通常为零#
在密码学噪声模型中,高斯分布通常以零为中心。原因很简单:噪声不应在某个方向上对系统产生系统性的偏置。如果误差有偏,秘密或解密值就可能泄露信息。
10.5为什么不能在 LWE 中直接使用连续高斯分布#
高斯分布是连续分布。它可以产生如下这样的实数: \[0.1352, \quad -1.2398, \quad 2.8888.\] 然而,LWE 定义在有限环或有限域上,通常是模 \(q\) 的。误差的各个坐标必须表示为模 \(q\) 的整数。
因此,我们使用高斯分布的离散版本。
10.6离散高斯分布#
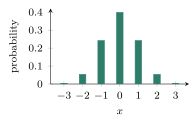
离散高斯分布(discrete Gaussian)为一个离散的整数集合赋予概率,例如 \[-3,-2,-1,0,1,2,3.\] 越靠近零,概率越大;离零越远,概率越小。一种典型的定义是 \[\Pr(e=x) = \frac{e^{-x^2/(2\sigma^2)}}{Z},\] 其中 \(Z\) 是归一化常数,保证总概率为 \(1\)。
这类分布之所以重要,是因为它契合基于格的密码的数学结构,并出现在许多安全性证明中。
10.7为什么离散高斯分布如此重要#
离散高斯采样在 Regev 式归约以及格问题的理论分析中处于核心地位。在许多证明中,高斯分布不只是方便而已,而是必不可少的。如果把它换成别的分布,归约论证可能就不成立了。
10.8走向 CBD:Kyber 实际采用的分布#
离散高斯分布在理论上固然优雅,在实践中却颇为棘手:要把它采样好,需要指数运算、浮点比较或拒绝采样循环——这些都很慢,而且都难以做到常数时间,以至于一个草率的采样器会通过其运行时间泄露秘密。出于这一工程上的原因,Kyber 放弃了高斯分布,转而采用中心二项分布(centered binomial distribution, CBD):这是一种仅用比特构造的分布,只需对若干次抛硬币的结果求和即可得到,其钟形足以在安全性上近似高斯分布,同时又能轻而易举地以常数时间采样。
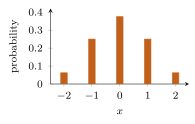
CBD 足够重要——而且足够特定于 ML-KEM——值得单独成章:第 15 章将完整地展开它,从“分别数出两半中 1 的个数再相减”的做法,一直讲到 FIPS 203 中确切的采样过程及其常数时间性质。这里我们只是把它放在噪声分布演进序列的末端。
10.9\(\sigma\) 是什么意思?#
在高斯模型中,参数 \(\sigma\) 控制误差的大小。若 \(\sigma=0.5\),则大多数误差都非常小;若 \(\sigma=100\),则噪声巨大,系统会变得不稳定。在实践中,设计目标是让 \(\sigma\) 足够大以隐藏秘密,又足够小以使解密仍能以高概率成功。
10.10尾界#
高斯分布在理论上是无界的,但在实践中,出现极大误差的概率微乎其微。当密码学家谈论一个分布的尾部时,他们指的是取值远离中心的概率。尾部短是有益的,因为这意味着极端误差很罕见,有助于保证正确性。
10.11噪声预算#
每个基于 LWE 和 RLWE 构建的方案都在每个密文中携带一个小的误差项,而正确解密依赖于将该误差保持在某个固定阈值以下——即噪声预算(noise budget)。其中的张力是根本性的:噪声选得太小,底层问题就会变得容易,方案因而不安全;噪声选得太大,诚实的解密就会失败。后续章节在为基于 RLWE 的加密和 ML-KEM 确定具体参数时,会再回到这一平衡,那里的设计会把解密失败概率压低到可忽略的水平。管理正确性与安全性之间的余量,是基于格的密码中核心的实际挑战之一。
10.12为什么密码学偏爱高斯噪声#
密码学偏爱高斯噪声,主要有三个原因。
它在数学上优雅,便于推理。
它与基于格的证明和归约自然契合。
它与最坏情形格困难性之间有很强的理论联系。
简而言之,噪声的存在不只是为了让事情变得随机。它被用来在正确性与安全性之间建立平衡。
如果噪声太小,秘密就更容易被恢复。
如果噪声太大,合法用户就无法正确解密。
各方案中 \(q\)、\(n\)、\(\eta\)、\(\sigma\) 等参数的选取,正是为了权衡这些取舍。
10.13小结#
本章的思路链条从最简单的随机性一直延伸到 ML-KEM 实际使用的分布: \[\text{Uniform} \;\longrightarrow\; \text{Gaussian} \;\longrightarrow\; \text{Discrete Gaussian} \;\longrightarrow\; \text{Centered Binomial Distribution (CBD)}.\] 均匀噪声易于采样,但对于正确解密而言太“野”;(离散)高斯分布是大多数安全性证明背后在理论上方便的选择;CBD 则是 Kyber 实际采用的折中方案,仅由抛硬币结果之和构造而成。图 10.1直接比较了这三种形状:均匀分布的直方图是平坦的,而离散高斯分布和 CBD(\(\eta=2\)) 都已呈现出熟悉的钟形,集中在零附近。
核心思想是:噪声并不仅仅是一种随机的副产品。它是使 LWE 及相关体制既安全又可解密的主要机制之一。
评论