第 17 章ML-DSA(FIPS 204)的完整实现
17.1学习目标#
本书前一部分一路推进到 FIPS 203,即用于加密与密钥交换的正式 ML-KEM 标准。现在我们转向公钥密码的另一半——数字签名,并进入三个签名标准中的第一个:FIPS 204,即 ML-DSA,它更为人熟知的是其提交时的名称 Dilithium [1, 2]。
学完本章后,你应当能够:
说明签名方案做什么,以及它与 KEM 有何不同;
理解 ML-DSA 的密钥生成流程,并看到它几乎原封不动地复用了 Kyber 的模格机制;
说明两个困难问题——模 LWE 与模 SIS——以及它们各自保护方案的哪一部分;
逐阶段理解签名过程,并明白其中为何包含一个拒绝(“中止”)循环;
把拒绝的思想与 LWE 各章所研究的噪声作用联系起来。
17.2回顾:签名与 ML-KEM 有何不同#
ML-KEM 回答的问题是:双方如何就一个共享秘密达成一致?签名回答的是另一个问题:验证者如何知道一条消息确实来自秘密钥的持有者,且未被改动?三个算法在形式上与 KEM 相对应,但服务于这一新目标:
KeyGen \(\to\) 公开的验证密钥 \(pk\) 与秘密的签名密钥 \(sk\);
Sign\((sk, M)\) \(\to\) 消息 \(M\) 上的签名 \(\sigma\);
Verify\((pk, M, \sigma)\) \(\to\) 接受或拒绝。
安全目标是不可伪造性:即使看过许多有效签名,没有 \(sk\) 的人也无法对一条新消息生成有效签名。值得注意的是,ML-DSA 正是在我们为 Kyber 构建的完全相同的环 \(R_q = \mathbb{Z}_q[x]/(x^{256}+1)\) 和模结构上实现这一目标的。只有模数改变了(\(q = 8380417\)),而签名过程则是真正全新的。
17.3两个困难问题#
ML-DSA 依赖于第 13 章模设定下的两个格问题。
模 LWE,我们已经熟悉:给定 \((A,\ \mathbf{t}=A\mathbf{s}_1+\mathbf{s}_2)\),其中 \(\mathbf{s}_1,\mathbf{s}_2\) 较短,恢复秘密是困难的。它把签名密钥隐藏在公钥之中。
模 SIS(短整数解,Short Integer Solution):第 11.7 节引入的 SIS 问题的模格形式。给定随机的 \(A\),找到满足 \(A\mathbf{z}=\mathbf{0}\pmod q\) 的短非零向量 \(\mathbf{z}\) 是困难的。它阻止伪造:伪造者必须给出一个满足某个公开方程的短向量。
SIS 是 LWE 的镜像。LWE 把秘密隐藏在噪声之中;SIS 则要求你为一个随机方程组找到一个短解。二者困难的几何原因相同——在高维格中很难找到短向量。
17.4FIPS 204 中的真实输入#
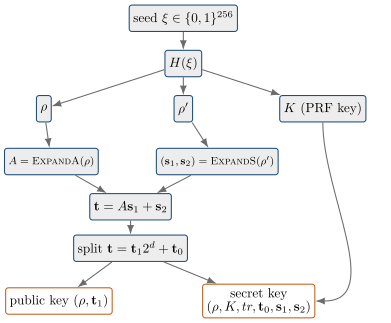
与 FIPS 203 完全一样,密钥生成并不从采样矩阵开始,而是从单个短种子开始: \[\xi \in \{0,1\}^{256}.\] 其余一切——公开矩阵、两个秘密向量以及内部的 PRF 密钥——都由 \(\xi\) 确定性地扩展得到。因此,与 ML-KEM 一样,密钥生成是一个确定性函数 \(\mathrm{KeyGen}(\xi)\)。
17.5阶段 1:扩展种子#
种子经 \(H\)(基于 SHAKE-256 构建)哈希后分为三部分: \[(\rho,\ \rho',\ K) = H(\xi).\] 它们的作用是:
\(\rho\)——公开,扩展为矩阵 \(A\)(它将存储在公钥中);
\(\rho'\)——秘密,作为采样 \(\mathbf{s}_1\) 与 \(\mathbf{s}_2\) 的种子;
\(K\)——秘密,一个 PRF 密钥,稍后用于派生每次签名的随机性。
17.6阶段 2:生成矩阵#
与 Kyber 一样,矩阵从不存储,而是按需从其种子重新生成: \[A = \text{E}{\small\text{XPAND}}\text{A}(\rho) \in R_q^{k\times \ell}.\] 维数 \((k,\ell)\) 正是区分三个安全级别的参数。
17.7阶段 3:采样秘密向量#
两个短秘密由 \(\rho'\) 扩展得到: \[(\mathbf{s}_1,\ \mathbf{s}_2) = \text{E}{\small\text{XPAND}}\text{S}(\rho'),\qquad \mathbf{s}_1\in R_q^\ell,\ \mathbf{s}_2\in R_q^k,\] 其系数位于较小的范围 \([-\eta,\eta]\) 内。它们扮演 LWE 秘密与误差的角色。
17.8阶段 4:计算并拆分公开值#
公开值就是熟悉的模 LWE 方程: \[\mathbf{t} = A\mathbf{s}_1 + \mathbf{s}_2.\] 为缩小公钥,\(\mathbf{t}\) 被拆分为高位部分 \(\mathbf{t}_1\)(公开)和低位部分 \(\mathbf{t}_0\)(保存在秘密钥中): \[\mathbf{t} = \mathbf{t}_1\cdot 2^{d} + \mathbf{t}_0.\] 公钥为 \((\rho, \mathbf{t}_1)\);秘密钥则打包了 \((\rho, K, \mathbf{t}_0, \mathbf{s}_1, \mathbf{s}_2)\),以及签名时使用的哈希值 \(tr = H(pk)\)。
17.9插曲:Fiat–Shamir 变换#
在深入 ML-DSA 的签名之前,值得先把它所用的通用技术单独拿出来讨论,因为这是一个基本构件,其应用远不止这一个方案。
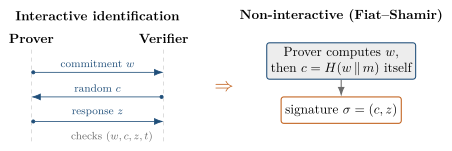
身份识别方案(identification scheme)让证明者在不泄露 \(s\) 的前提下,使验证者相信它知道秘密 \(s\)(其公开像为 \(t\))。这是一段三轮对话:证明者发送承诺 \(w\);验证者回复随机挑战 \(c\);证明者发送只有知道 \(s\) 的人才能给出的响应 \(z\),验证者检查 \((w,c,z,t)\) 之间的某个关系。如果响应经过恰当的随机化,则整段记录不泄露关于 \(s\) 的任何信息。
Fiat–Shamir 变换 [3]通过去掉验证者,把这一交互式协议变为签名。证明者不再等待随机挑战,而是自己把挑战计算为承诺与消息一起的哈希值: \[c = H(w \,\|\, m).\] 由于 \(H\) 的行为如同一个不可预测的随机函数,证明者无法把 \(c\) 引向对自己有利的方向;又由于 \(c\) 依赖于 \(m\),整段记录便与该消息绑定——它就是 \(m\) 上的一个签名。
17.10签名的思想:承诺、挑战、响应#
签名恰好实例化了上述身份识别记录,由模格对象分别扮演承诺、挑战和响应的角色:
承诺。采样一个随机的短掩码向量 \(\mathbf{y}\),并构造 \(\mathbf{w} = A\mathbf{y}\)。
挑战。先构造消息代表值 \(\mu=H(tr\,\|\,M')\),其中 \(M'\) 包含任何上下文或预哈希格式。然后计算 \(\tilde c=H(\mu\,\|\,\mathbf{w}_1)\),其中 \(\mathbf{w}_1=\text{H}{\small\text{IGH}}\text{B}{\small\text{ITS}}(\mathbf{w})\),并导出 \(c=\text{S}{\small\text{AMPLE}}\text{I}{\small\text{N}}\text{B}{\small\text{ALL}}(\tilde c)\)。
响应。以 \(\mathbf{z} = \mathbf{y} + c\,\mathbf{s}_1\) 作答。
于是验证者可以重新计算 \(A\mathbf{z} - c\,\mathbf{t}\),并检查它在高位上与 \(\mathbf{w}\) 一致,因为 \[A\mathbf{z} - c\,\mathbf{t} = A(\mathbf{y}+c\,\mathbf{s}_1) - c(A\mathbf{s}_1+\mathbf{s}_2) = A\mathbf{y} - c\,\mathbf{s}_2 \approx \mathbf{w}.\] 剩余的 \(c\,\mathbf{s}_2\) 很小,HighBits 的舍入会将其吸收。用哈希 \(H\) 取代交互式验证者,正是 Fiat–Shamir 变换:哈希充当一个不可预测、不可操纵的挑战者。
17.11为什么签名有时必须中止#
响应 \(\mathbf{z} = \mathbf{y} + c\,\mathbf{s}_1\) 直接携带了秘密 \(\mathbf{s}_1\)。如果掩码 \(\mathbf{y}\) 不够大,不足以淹没 \(c\,\mathbf{s}_1\),那么 \(\mathbf{z}\) 就会泄露信息——在许多签名上取平均后,掩码相互抵消,秘密便显露出来。这是换了装扮的 LWE 教训:掩码必须完全隐藏秘密。
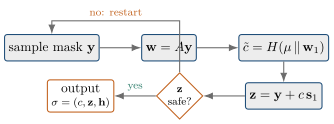
ML-DSA 的解决办法是拒绝采样(rejection sampling),也称为带中止的 Fiat–Shamir。构造出 \(\mathbf{z}\) 后,签名者检查它是否落在一个安全区域内,在该区域内其分布与 \(\mathbf{s}_1\) 无关。如果不是,就丢弃一切,重新抽取新的 \(\mathbf{y}\) 并重试。只有不泄露信息的 \(\mathbf{z}\) 才会被发布。
17.12签名与验证#
把各阶段合在一起,就得到签名算法。安全区域由两个界刻画:\(\|\mathbf{z}\|_\infty\) 必须保持在 \(\gamma_1-\beta\) 以下,且 \(\mathbf{w}-c\mathbf{s}_2\) 的低位必须保持在 \(\gamma_2-\beta\) 以下。提示 \(\mathbf{h}\) 用于弥补被省略的 \(\mathbf{t}_0\)。
验证过程由公开数据重新计算承诺,检查挑战哈希是否一致,同时确认 \(\mathbf{z}\) 确实是短的——正是这一短向量检查让伪造者面对模 SIS 问题。
由于 \(A\mathbf{z} - c\,\mathbf{t} = A\mathbf{y} - c\mathbf{s}_2\) 在高位上与 \(\mathbf{w}=A\mathbf{y}\) 一致,而提示又修补了只公开 \(\mathbf{t}_1\) 所留下的差距,因此当且仅当签名真实时,双方才会哈希出相同的挑战。
17.13伪造者为何无路可走#
没有 \(sk\) 的攻击者可以任意选择 \(\mathbf{z}\) 和 \(c\),但要通过验证,就必须满足 \(c = H(\mu\,\|\,\text{H}{\small\text{IGH}}\text{B}{\small\text{ITS}}(A\mathbf{z}-c\mathbf{t}))\),并且保持 \(\mathbf{z}\) 是短的。由于 \(H\) 的行为如同随机函数,其输出无法被操控;唯一的途径是找到一个与该方程相容的真正短的 \(\mathbf{z}\)——这就是一个模 SIS 实例。而攻击者也无法转而从公开数据中获知 \(\mathbf{s}_1\),因为那是模 LWE 问题。两个困难问题同时堵住了两扇门。
17.14SageMath 实验#
核心的抵消关系很容易在缩小版中验证。使用小参数,采样一个密钥,构造一个加了掩码的响应,并在发布任何签名之前就确认验证恒等式成立。
# Toy sizes; real ML-DSA uses n=256, q=8380417.
from random import Random
from sage.all import GF, Matrix, PolynomialRing, vector

q = 8380417
R.<x> = PolynomialRing(GF(q))
Rq = R.quotient(x^8 + 1)  # toy ring
rng = Random("mldsa-cancellation")

def small_poly():
    return Rq([rng.choice([-1, 0, 1]) for _ in range(8)])

def uniform_poly():
    return Rq([rng.randrange(q) for _ in range(8)])

A = Matrix(Rq, 2, 2, [uniform_poly() for _ in range(4)])
s1 = vector(Rq, [small_poly(), small_poly()])
s2 = vector(Rq, [small_poly(), small_poly()])
t = A * s1 + s2
y = vector(Rq, [uniform_poly(), uniform_poly()])
c = small_poly()
# For a mask y and challenge c, check the verifier's identity:
#   A*z - c*t  ==  A*y - c*s2   (should hold exactly)
z = y + c*s1
assert A*z - c*t == A*y - c*s2
然后用若干个掩码重复实验,统计 \(\|\mathbf{z}\|_\infty\) 超出界的频率:这恰好就是拒绝率,它说明了为什么一次签名需要少量且次数不定的尝试。
17.15完整的 SageMath 实现#
上面的抵消检查只是一个片段。配套文件 sage/fips204_mldsa.sage 则是整个标准:FIPS 204 中全部四十九个编号算法,每个都实现为独立的函数并注明其算法编号,覆盖 ML-DSA-44、65 和 87。其中包括本章当作黑盒处理的部分——ExpandA、ExpandS、 ExpandMask、SampleInBall、Power2Round、 Decompose、MakeHint、UseHint——以及位打包、提示编码、预哈希变体 HashML-DSA 和 Montgomery 约简。
在浏览器中运行:ML-DSA-44、65 和 87 三个参数集上的密钥生成、签名与验证。参见 appliedpqc.io/playground.html,无需安装。
与 FIPS 203 一样,代数运算由 Sage 承载。不过这里标准细心地区分了环 \(R_q\) 与系数范围受限的整系数多项式环 \(R\),代码也同样如此:模 \(q\) 约简的量(秘密 \(\mathbf{s}_1,\mathbf{s}_2\)、掩码 \(\mathbf{y}\)、响应 \(\mathbf{z}\))位于 Sage 商环 \(R_q = \mathbb{F}_{8380417}[X]/(X^{256}+1)\) 中,而 \(\mathbf{t}_1\)、 \(\mathbf{w}_1\)、\(\mathbf{r}_0\) 以及提示 \(\mathbf{h}\) 则保持为整数列表。 NTT 域 \(T_q\) 是直积 \((\mathbb{Z}_q)^{256}\),因此 MultiplyNTT(算法 45)实际上就是逐坐标乘积。
于是,算法 21 的拒绝循环读起来几乎与标准中的写法完全一致:
kappa = 0
while True:
    y  = self.ExpandMask(rhopp, kappa)
    yh = [NTT(Rq(p)) for p in y]
    w  = [NTTInverse(a) for a in MatrixVectorNTT(Ah, yh)]
    w1 = HighBitsVec(w, self.gamma2)

    ctilde = H(mu + self.w1Encode(w1), self.lam // 4)
    c      = self.SampleInBall(ctilde)
    ch     = NTT(Rq(c))

    cs1  = [NTTInverse(MultiplyNTT(ch, a)) for a in s1h]
    cs2  = [NTTInverse(MultiplyNTT(ch, a)) for a in s2h]
    z    = [Rq(y[i]) + cs1[i] for i in range(self.ell)]
    wcs2 = [w[i] - cs2[i] for i in range(self.k)]
    r0   = LowBitsVec(wcs2, self.gamma2)

    kappa += self.ell
    if inf_norm_vec(z) >= self.gamma1 - self.beta:      # unsafe: retry
        continue
    if inf_norm_ints(r0) >= self.gamma2 - self.beta:
        continue

    ct0 = [NTTInverse(MultiplyNTT(ch, a)) for a in t0h]
    h   = MakeHintVec([-p for p in ct0],
                      [wcs2[i] + ct0[i] for i in range(self.k)],
                      self.gamma2)
    if inf_norm_vec(ct0) >= self.gamma2:
        continue
    if sum(sum(p) for p in h) > self.omega:
        continue

    return self.sigEncode(ctilde, [centered(zi) for zi in z], h)
每个 continue 都对应图 17.3 中一次被丢弃的尝试;在大量签名上统计它们,就能重现参数表中的“重复次数”一行,对 ML-DSA-44 而言大约为四次。另请注意,\(\kappa\) 在检查之前就已递增,因此每次重试都会抽取一个真正新鲜的掩码。
对照代数检验变换。#
sage/fips204_mldsa.sage 末尾的函数 verify_ntt_is_a_ring_isomorphism() ——与第 16 章中 ML-KEM 的检查同名,但作用于另一个环——借助 Sage 确认:\(\mathrm{NTT}^{-1}\) 是 \(\mathrm{NTT}\) 的逆;第 \(j\) 个 NTT 系数是取值 \(w(\zeta^{2\,\mathrm{BitRev8}(j)+1})\),这正是使 \(T_q\) 成为直积的原因;以及 MultiplyNTT 如实传递了 Sage 所计算的 \(R_q\) 中的乘法。它还检查 MontgomeryReduce 确实返回 \(a\cdot 2^{-32} \bmod q\)。
验证。#
该实现以 NIST 针对 FIPS 204 的 ACVP 向量 [4]进行检验——包括密钥生成、签名生成与签名验证——并逐字节重现了这些向量。签名生成向量要求最高,因为它们覆盖了标准所允许的每一种组合:确定性签名与对冲(hedged)签名,纯消息编码与预哈希消息编码(遍及全部十二个获批的预哈希函数),外部与内部签名接口,以及外部 \(\mu\) 模式——在该模式下,消息代表值在一个单独的密码模块中计算。在 latex/ 目录下运行 make kat 即可。
17.16常见陷阱#
陷阱 1:以为掩码可以重复使用或取得很小。#
掩码 \(\mathbf{y}\) 必须在每次尝试中都是新鲜的,并且足够大以隐藏 \(c\,\mathbf{s}_1\)。重复使用掩码,或为了避免拒绝而缩小掩码,都会泄露秘密。这正是设置中止循环的全部原因。
陷阱 2:以为中止循环会造成关于秘密的计时泄露。#
迭代次数取决于掩码,而掩码是新鲜的随机性,并不以可被利用的方式依赖于秘密。FIPS 204 由 \(K\,\|\,rnd\,\|\,\mu\) 派生掩码种子:选择全零的 \(rnd\) 得到确定性签名,而新鲜的 \(rnd\) 则支持随机化签名或对冲签名。
陷阱 3:以为 \(A\) 存储在密钥中。#
与 ML-KEM 一样,\(A\) 每次都由 \(\rho\) 重新生成。公钥只有 \((\rho,\mathbf{t}_1)\)。
17.17参数集#
| 方案 | \((k,\ell)\) | NIST 级别 | 相当于 |
|---|---|---|---|
| ML-DSA-44 | \((4,4)\) | 2 | AES-128 |
| ML-DSA-65 | \((6,5)\) | 3 | AES-192 |
| ML-DSA-87 | \((8,7)\) | 5 | AES-256 |
17.18小结#
ML-DSA 复用了 Kyber 的模格体系,并加入了一个真正全新的要素——带中止的 Fiat–Shamir:
密钥生成是由单个种子 \(\xi\) 进行的确定性扩展,与 FIPS 203 完全一样;
签名是一段借助哈希实现非交互化的承诺—挑战—响应记录;
响应 \(\mathbf{z}=\mathbf{y}+c\,\mathbf{s}_1\) 携带秘密,因此只有当拒绝采样确认它完全隐藏了秘密时才会被发布;
不可伪造性依赖于模 LWE(隐藏密钥)和模 SIS(阻止短向量伪造)。
下一章仍停留在格上,但走了一条截然不同的签名路线:FN-DSA(Falcon)。它放弃 Fiat–Shamir,转而在 NTRU 格上采用哈希后签名(hash-and-sign)构造,并以此换来了三个标准中最紧凑的签名。
评论