第 21 章SLH-DSA(SPHINCS+,FIPS 205):算法详解
21.1什么是 SPHINCS+?#
SPHINCS+ 是 NIST 在 FIPS 205 [1, 2] 中标准化为 SLH-DSA 的基于哈希的签名方案,它是所有后量子标准中最保守的一个。上一部分的格签名依赖于格问题被假定的困难性,而 SPHINCS+ 仅仅依赖于哈希函数的安全性——这是密码学中被理解得最透彻的单一假设。即使明天所有的格假设和编码假设都被攻破,一个安全的哈希函数仍然能够产生安全的签名;这正是该方案族被保留在标准组合中作为对冲的原因。
该方案是一条简短谱系的终点:无状态设计 SPHINCS 于 2015 年问世,在 2017–2019 年间为参加 NIST 竞赛而被强化为 SPHINCS+ [2],并于 2024 年在 FIPS 205 中最终定型为 SLH-DSA。这三个名称指代的基本上是同一个构造;本书用 SLH-DSA 指称标准化后的算法,用 SPHINCS+ 指称其前身方案。用一句话概括,它是一棵由一次性与少次哈希签名构成的巨型超树,其排布方式使得永远无需保存任何签名状态。
为什么“无状态”是难点。#
SLH-DSA 中的 “SL” 代表无状态(stateless),而这正是该设计竭力争取的性质。较早的基于哈希的方案,如 XMSS 和 LMS,是有状态的:每个一次性密钥只能恰好使用一次,因此签名者必须记住哪些叶子已被用掉,而一次疏忽——恢复了一个虚拟机快照、复制了一个密钥文件——就会重用一次性密钥,并可能造成灾难性后果。SPHINCS+ 彻底消除了状态。它使用消息随机化和一个极其庞大的超树地址空间,使意外的地址碰撞可以忽略。这并不意味着允许重用地址:WOTS 叶子必须保持唯一,而 FORS 的安全性会随有限的签名次数以及任何意外碰撞而退化。无状态的代价是尺寸:SPHINCS+ 的签名是所有标准中最大的,每个签名有数 KB。该方案可以用 SHA-2 或 SHAKE 实例化,有 simple(简单)和 robust(稳健)两种模式,并分为下文参数一节中详述的、在尺寸与速度之间取舍的 s 族和 f 族。
21.2学习目标#
前两章从零开始构建了基于哈希的签名的各个组件:一次性签名与少次签名(第 19 章),以及使它们成为无状态、可多次使用的 Merkle 树与超树机制(第 20 章)。本章完全按照标准的规定把这些组件组装起来。读完本章后,你应当能够:
解释为何 SPHINCS+ 是最保守的标准,以及“无状态”带来了什么、付出了什么代价;
回忆 WOTS+、FORS、Merkle 树和超树是如何组合在一起的;
解释每个秘密值如何由少数几个种子和一个地址确定性地派生出来;
理解 SLH-DSA 的密钥生成、签名和验证算法;
读懂各参数族及其在尺寸与速度之间的权衡。
21.3回顾:组装起来的各个组件#
值得在一处重新陈述这一阶梯,因为 SLH-DSA 恰恰就是它的组装:
WOTS+(第 19 章)用哈希链和校验和对一个值签名;
一棵 Merkle 树(第 20 章)把 \(2^h\) 个 WOTS+ 密钥绑定在一个根之下,并由一条路径进行认证——一棵这样的树就是一个 XMSS 实例;
一棵超树把 \(d\) 层这样的树堆叠起来,使每个根都由上一层签名,只把顶端的根作为公钥公开;
FORS 作为一种少次签名对实际的消息摘要签名,而它的公钥正是超树最底层所签名的对象。
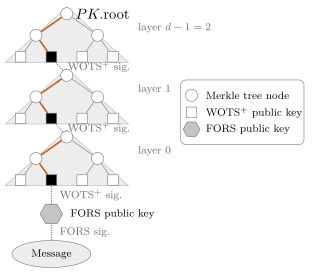
图 21.1 画出了一个完整的 SLH-DSA 签名:从底部的消息一直到已公布的根的整条一次性签名与少次签名链(同一超树的模块级视图见图 20.2)。剩下要做的是明确每个秘密值从何而来,并写出三个算法。
21.4真正的输入:种子与地址#
与 ML-KEM 和 ML-DSA 一样,SLH-DSA 一旦固定了种子便是确定性的。一切都由三个 \(n\) 字节的值派生而来:
SK.seed——秘密;每个 WOTS+ 和 FORS 秘密值都通过一个 PRF 由它生成;SK.prf——秘密;一个 PRF 密钥,用于派生每个签名各自的随机化值 \(R\);PK.seed——公开;对每次哈希进行调整,使结构上相同的节点互不相同。
使众多哈希保持彼此区分的机制是地址(ADRS):一个结构化的标签,准确标识某次哈希属于哪棵树、哪一层、哪个叶子以及链中的哪个位置。每次哈希调用都接收公开种子和一个地址,因此在不同位置上结构相同的两次计算绝不会产生相同的值。这正是挫败多目标攻击的关键,也是为什么 PK.seed 虽然公开,却不可或缺。
21.5密钥生成#
密钥生成采样三个种子,并计算概括整棵超树的那一个值:其顶层 Merkle 树的根。
SK.seed、SK.prf、PK.seedSK.seed 和 PK.seed 通过带地址的哈希派生21.6签名与验证#
签名过程把消息(连同一个随机化值)哈希为摘要,将摘要拆分为一条 FORS 消息以及一对用于选择底层树和叶子的索引,用 FORS 对摘要签名,然后沿超树向上对 FORS 公钥签名。
验证不过是一连串的哈希重新计算:由消息重建 FORS 公钥,利用所提供的认证路径沿超树向上折叠,只有当最终值等于已公布的根时才接受。这里没有需要保护的算术运算,也没有依赖于秘密的分支,这使得 SLH-DSA 异常容易以常数时间实现(第 26 章)。
21.7参数集#
SLH-DSA 在每个安全级别上都有两种版本:s(小签名,签名较慢)和 f(快速签名,签名较大),可用 SHA2 或 SHAKE 实例化。
| 参数族 | \(n\)(字节) | NIST 级别 | 权衡 |
|---|---|---|---|
| SLH-DSA-128{s,f} | 16 | 1 | 密钥最小 |
| SLH-DSA-192{s,f} | 24 | 3 | 均衡 |
| SLH-DSA-256{s,f} | 32 | 5 | 安全性最高 |
签名很大——大约 \(8\) 到 \(50\) KB——这是仅依赖哈希所付出的代价。作为回报,其安全性论证是所有后量子方案中最简单、最保守的。
21.8SageMath 实验:带地址的 Merkle 认证#
这个仅使用哈希的小例子检验 SLH-DSA 验证中把认证路径折叠回公开根的那一部分。它使用八个叶子和一个基于 SHA-256 的玩具版哈希;它不是 FORS、WOTS+ 或完整 SLH-DSA 的实现。
from hashlib import sha256
from operator import xor

n = 16
pk_seed = b"public seed for a toy tree"

def H(label, address, data=b""):
    return sha256(pk_seed + label + address + data).digest()[:n]

def leaf(index):
    return H(b"leaf", int(index).to_bytes(4, "big"))

def parent(left, right, level, index):
    address = (int(level).to_bytes(1, "big") +
               int(index).to_bytes(4, "big"))
    return H(b"node", address, left + right)

levels = [[leaf(i) for i in range(8)]]
for level in range(3):
    previous = levels[-1]
    levels.append([parent(previous[2*i], previous[2*i + 1], level, i)
                   for i in range(len(previous)//2)])
root = levels[-1][0]

leaf_index = 5
auth = [levels[level][xor(int(leaf_index >> level), 1)]
        for level in range(3)]

def root_from_path(node, index, path):
    for level, sibling in enumerate(path):
        parent_index = index >> 1
        node = (parent(node, sibling, level, parent_index)
                if index % 2 == 0 else
                parent(sibling, node, level, parent_index))
        index >>= 1
    return node

assert root_from_path(leaf(leaf_index), leaf_index, auth) == root
bad_auth = list(auth)
bad_auth[0] = bytes([xor(bad_auth[0][0], 1)]) + bad_auth[0][1:]
assert root_from_path(leaf(leaf_index), leaf_index, bad_auth) != root
print("addressed Merkle path accepts intact data and rejects a tampered path")
地址被包含在每次哈希调用之中,因此位于不同层或不同节点索引处的相同字节串会被域分离。这就是贯穿整个 SLH-DSA 的地址规范的小规模版本。
21.9一个完整的 SageMath 实现#
上面的 Merkle 实验在一个要紧的方面是玩具版的:它使用了一个虚构的地址格式。配套文件 sage/fips205_slhdsa.sage 实现了真正的方案——FIPS 205 中全部二十五个编号算法,每个算法都是一个独立的函数,并标注了其算法编号,覆盖全部十二个获批的参数集。这意味着两个哈希族(SHA2 和 SHAKE)、全部三个安全级别、s 和 f 两种变体都包括在内,此外还有 WOTS+ 链、XMSS 树、超树、FORS、纯消息(pure)与预哈希(pre-hash)两种顶层算法,以及 32 字节的地址结构及其 22 字节的压缩形式。
在浏览器中运行:f 参数集的端到端运行,以及 s 参数集(其签名需要数分钟)对照 NIST ACVP 签名的验证。参见 appliedpqc.io/playground.html,无需安装。
地址是一个小类,携带标准表 1 中的各个成员函数,因此算法 9 的递归树遍历读起来与规范完全一致:
def xmss_node(self, skseed, i, z, pkseed, adrs):
    """Algorithm 9. Root of a Merkle subtree of WOTS+ public keys."""
    if z == 0:
        adrs.setTypeAndClear(WOTS_HASH)
        adrs.setKeyPairAddress(i)
        return self.wots_pkGen(skseed, pkseed, adrs)
    lnode = self.xmss_node(skseed, 2*i,     z - 1, pkseed, adrs)
    rnode = self.xmss_node(skseed, 2*i + 1, z - 1, pkseed, adrs)
    adrs.setTypeAndClear(TREE)
    adrs.setTreeHeight(z)
    adrs.setTreeIndex(i)
    return self._H(pkseed, adrs, lnode + rnode)
超树于是不过是把这种树堆叠 \(d\) 层,每一层对其下一层的根签名:
def ht_sign(self, M, skseed, pkseed, idxtree, idxleaf):
    """Algorithm 12. A hypertree signature: d chained XMSS signatures."""
    adrs = ADRS()
    adrs.setTreeAddress(idxtree)
    SIGtmp = self.xmss_sign(M, skseed, idxleaf, pkseed, adrs)
    SIG_HT = SIGtmp
    root   = self.xmss_pkFromSig(idxleaf, SIGtmp, M, pkseed, adrs)
    for j in range(1, self.d):
        idxleaf = idxtree % (1 << self.hp)   # low h' bits
        idxtree = idxtree >> self.hp
        adrs.setLayerAddress(j)
        adrs.setTreeAddress(idxtree)
        SIGtmp  = self.xmss_sign(root, skseed, idxleaf, pkseed, adrs)
        SIG_HT += SIGtmp
        if j < self.d - 1:
            root = self.xmss_pkFromSig(idxleaf, SIGtmp, root, pkseed, adrs)
    return SIG_HT
对于一个没有代数结构的方案,Sage 能贡献什么。#
SLH-DSA 完全由哈希函数构建,因此与 ML-KEM 和 ML-DSA 不同,这里没有可供计算机代数系统用来核对代码的环。Sage 所提供的则是关于其组合结构的精确整数推理。位于 sage/fips205_slhdsa.sage 末尾的函数 verify_parameter_consistency() 针对全部十二个参数集,从定义方程重新推导出表 2:验证 \(h = d\cdot h'\),从而超树确实有 \(2^{h}\) 个叶子;验证由算法 1 得出的校验和长度 \(len_2\) 与闭式 \(\lfloor \log_w(len_1(w-1)) \rfloor + 1\) 一致,后者用 Sage 的精确整数对数计算;验证摘要长度 \(m\) 足以提供 FORS 消息以及两个树索引;并验证已公布的密钥尺寸和签名尺寸分别等于 \(2n\) 与 \((1 + k(1+a) + h + d\cdot len)\,n\)。参数表恰恰是那种容易抄错、又难以察觉的东西,而这一函数把它变成了一项测试。
验证。#
该实现针对 NIST 的 FIPS 205 ACVP 向量 [3] 进行了检验——包括密钥生成、签名生成和签名验证,覆盖全部十二个参数集的纯消息形式与预哈希形式——并逐字节地复现了这些向量。
有一个实际的注意事项是方案本身的性质,而非本实现的性质。使用 s 参数集签名需要重建整棵 XMSS 树:SLH-DSA-128s 每个签名需要遍历大约一百万次量级的哈希调用,在 Sage 中约需十六秒,而 256 比特的变体约需其两倍。因此,快速测试只对 f 参数集覆盖签名生成,并报告它略去了多少组;make kat-full 则把它们包括在内。验证对每个参数集来说开销都很小,因此总是被完整检验。正是这种不对称性给两种变体带来了各自的名称。
21.10常见陷阱#
陷阱 1:重用一次性(WOTS+)叶子。#
用同一条 WOTS+ 链对两条不同的消息签名,会揭示足以进行伪造的链上点(第 19 章)。地址机制和消息随机化使意外碰撞极不可能发生;WOTS 地址和 FORS 地址都不得被有意重用。
陷阱 2:以为 SLH-DSA 需要状态。#
较早的基于哈希的方案(XMSS、LMS)是有状态的:签名者必须记住哪些叶子已被用掉,一次重用就是灾难性的。SLH-DSA 是无状态的——由消息哈希来选择路径——这正是尽管签名更大,它仍被选中进行标准化的原因。
陷阱 3:忽视公开种子的作用。#
PK.seed 通过地址机制调整每一次哈希调用。没有它,不同树中结构相同的节点会得到相同的哈希值,从而使多目标攻击成为可能。它是公开的,但不可或缺。
21.11小结#
SLH-DSA 是把基于哈希的阶梯组装成单个无状态标准的结果:
每个秘密值都由
SK.seed和一个地址确定性地派生;PK.seed使所有哈希保持互不相同;一个签名是对消息摘要的 FORS 签名,经由一棵由 Merkle 树(XMSS)实例构成的超树向上传递,直到唯一公布的根;
验证纯粹是哈希运算,因此该方案在假设上保守,并且易于实现为常数时间。
它的安全性仅依赖于哈希函数,这使它成为后量子签名中的最后防线。至此,两大签名族——基于格的(ML-DSA、FN-DSA)和基于哈希的(SLH-DSA)——都已介绍完毕。下一部分将转向第三个相互独立的基础:基于编码的密码。
评论