第 26 章侧信道安全
26.1学习目标#
本书此前的每一章都是在纸面上论证安全性:某个格问题是困难的,伪造可以归约到 Module-SIS,区分器将攻破 LWE。这种安全性是必要的,但并不充分。方案并不在纸面上运行;它运行在一台物理设备上,这台设备要耗费时间、汲取电流、向外辐射,还可能被激光照射。只要这些可测量的物理量中有任何一个依赖于秘密钥,攻击者就能直接从机器上读出密钥,而根本无须触及其中的数学。本章的警告直截了当: 数学可以完美无缺,而部署仍然是破碎的。本章开启了本书讨论实践的最后一部分:正确且能抵御侧信道的实现,是将这些方案引入真实系统的若干要求之一,与之并列的还有协议集成与迁移,这些将在其后各章中讨论。
学完本章后,你应当能够:
解释为什么可证明的数学安全性是必要但不充分的,并准确说明什么是侧信道(side channel);
列举实现攻击的主要类别——计时、缓存、功耗、电磁和故障——并说明每一类实际观测的是什么;
陈述常数时间(constant-time)编程的规则,并写出常数时间的条件选择与常数时间的比较;
将这些思想与本书已经遇到的具体 PQC 设计选择联系起来:用 CBD 代替高斯采样(第 15 章)、 Falcon 的浮点采样器(第 18 章)、ML-DSA 的确定性中止循环(第 17 章), 以及 ML-KEM 解封装中内置的隐式拒绝(第 16 章);
描述高阶防护措施——掩码与盲化——并权衡其相对于常数时间编码的代价。
本章为何重要。#
Shor 算法是促成整本书的威胁,它攻击的是问题的结构:它分解整数,它计算离散对数。我们构建的方案之所以能抵御它,是因为对于其底层的格问题与码问题,尚无已知的高效量子算法。侧信道攻击做的是完全不同的事情。它不理会问题结构,而是测量执行过程:一次解密花了多长时间,它触及了哪些缓存行,芯片在每个时钟周期汲取了多少功率。这些攻击往往比数学攻击廉价得多——用示波器花几分钟,而不是在量子计算机上耗费亿万年——这正是它们之所以重要的原因。对 PQC 而言,这种担忧并非假想:本书中的若干方案有着精细的实现要求,而这些要求塑造了标准。这正是 ML-KEM 用 CBD 而非高斯分布来采样噪声的原因(第 15 章),也是 FN-DSA (基于 Falcon;FIPS 206 仍在制定中)在安全部署方面格外棘手的原因(第 18 章)。
26.2攻击类别#
侧信道是计算过程中除预期结果之外的任何可观测输出。下面是 PQC 实现者必须牢记的几类攻击。每一类用一段话概述;它们的共同点在于,都将一次物理测量转化为关于秘密的信息。
计时攻击。#
一次计算所花费的总时间取决于它所处理的数据 [1]。如果这些数据包含秘密,运行时间就会泄露它。教科书式的例子是一个在找到第一个不同字节时立即返回的比较:能够改变输入并对响应计时的攻击者,便可以逐字节地获知秘密。计时泄露是最危险的一类,因为它们无需专门设备,并且往往可以通过网络远程测量。
缓存攻击。#
现代 CPU 会缓存最近使用过的内存。如果程序在依赖秘密的位置上索引一张表——许多高斯采样器和密码 S 盒正是如此——那么哪些表项进入缓存就取决于秘密。与之共享同一台机器的攻击者(例如共驻的云租户)看不到这些值,但可以对其自身的内存访问计时,从而得知哪些缓存行被触及,所用技术如 Flush+Reload 或 Prime+Probe。因此,依赖秘密的内存地址与依赖秘密的计时同样会造成泄露。
功耗分析。#
芯片的瞬时功耗与它执行的操作以及它搬运的比特相关。简单功耗分析(SPA)读取单条迹线来识别操作序列——例如在模幂运算中区分乘法与平方,从而逐位拼出指数。差分功耗分析(DPA) [2]更为强大:它收集大量迹线,并逐个采样点地将其与关于少数几个密钥比特的假设进行相关分析,即使秘密远低于测量噪声,也能将其提取出来。
电磁分析。#
开关中的晶体管会产生辐射。功耗分析从电源线上读取的同样信息,也可以从芯片附近的电磁辐射中读取,往往只需一个小探头而无需电气接触。电磁分析还可以在空间上定位到芯片裸片的某个局部区域,这有时能够击败那些只平衡全局功耗的防护措施。
故障注入。#
上述攻击是被动的:它们只做观测。故障注入则是主动的。通过对电源电压或时钟施加毛刺,或向裸片发射激光或电磁脉冲,攻击者可以诱发受控的错误——跳过一条指令、翻转一个比特、破坏一个值——并利用由此产生的错误输出。签名方案在这方面尤其脆弱:借助差分故障分析,一个错误的签名就可能暴露签名密钥,而跳过一次边界检查则可能在 ML-DSA 这样的方案中泄露掩码。
26.3常数时间编程#
抵御依赖秘密的计时与缓存泄露的核心软件防线是常数时间编程。对于物理功耗或电磁攻击,它是必要的,但并不充分。这个名称略有误导性:其目标并不是让代码始终耗费相同的挂钟时间,而是让其计时、内存访问模式和操作序列不依赖于秘密数据。仅依赖于公开数据的变化(消息的长度、循环的公开迭代次数)是无妨的。
这一准则可以归结为三条规则:
不使用依赖秘密的分支。条件涉及秘密的
if会走这条或那条路径, 而两条路径的开销几乎从不相同。应以直线式的算术运算取代分支。不使用依赖秘密的内存索引。绝不要将秘密用作数组下标或跳转目标。 在秘密地址上的查表即使代码中完全没有分支,也会通过缓存泄露信息。
避免在秘密数据上使用可变时间的指令。除法与取模,以及在某些处理器上甚至乘法, 所需的周期数都依赖于数据。诸如
memcmp这样会提前退出的库例程是同一隐患的变体。 应使用固定开销的操作,或用 Montgomery/Barrett 算术代替硬件除法进行约简。
图 26.1 对比了这一隐患及其修正。左侧,一个秘密比特在短路径与长路径之间做出选择;二者持续时间的差异就是泄露。右侧,同样的选择借助掩码来计算,使得每个输入都执行完全相同的操作序列。
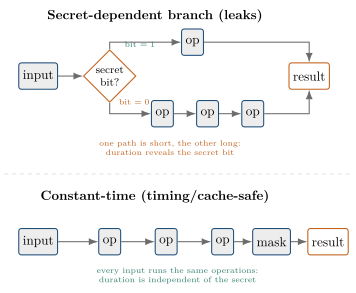
消除秘密分支的主力工具是常数时间选择。它将选择比特变成全 1 或全 0 的掩码,并用该掩码通过按位运算混合两个候选值,这样两个候选值总是都被计算,也不会执行任何分支。
技巧在于掩码 \(-s\):在二进制补码中对比特 \(1\) 取负得到全 1 字,对 \(0\) 取负得到全 0 字。当 \(s=1\) 时,第一项让 \(a\) 通过而第二项被清零;当 \(s=0\) 时,两者角色互换。这里没有分支,也没有依赖秘密的地址。同样的掩码思想给出了常数时间的相等性测试 ct_eq,它绝不能提前返回:它要在所有字节上累积差异,然后才将结果压缩为单个比特。
代码清单 26.1 用 C 语言展示了这两种模式:有泄露的分支、取代它的掩码写法,以及不提前退出的比较。
#include <stdint.h>
#include <stddef.h>

/* LEAKY: the branch condition is a secret; the two paths differ */
uint32_t leaky_select(int secret_bit, uint32_t a, uint32_t b) {
    if (secret_bit)      /* timing/cache/power all reveal which way */
        return a;
    else
        return b;
}

/* CONSTANT-TIME: no branch, no secret-dependent memory access */
uint32_t ct_select(uint32_t secret_bit, uint32_t a, uint32_t b) {
    uint32_t mask = -secret_bit;   /* 0xFFFFFFFF if 1, 0x00000000 if 0 */
    return (a & mask) | (b & ~mask);
}

/* CONSTANT-TIME equality: 1 if equal, else 0, never exits early */
uint32_t ct_eq(const uint8_t *x, const uint8_t *y, size_t n) {
    uint8_t diff = 0;
    for (size_t i = 0; i < n; i++)
        diff |= x[i] ^ y[i];       /* fold every byte, no break */
    /* top bit of (diff | -diff) is 1 iff diff != 0 */
    uint32_t nz = ((uint32_t)diff | (0u - (uint32_t)diff)) >> 31;
    return nz ^ 1u;                /* invert: equal -> 1 */
}26.4PQC 特有的问题#
常数时间准则是通用的,但后量子方案将风险集中在少数几个特定位置。下面每一项都可追溯到前面某一章所做的设计选择。
采样:CBD 存在的理由。#
格方案中的噪声在每次生成密钥或密文时都必须重新采样。离散高斯采样器是自然的数学选择,但它是侧信道的雷区:它通常需要拒绝循环(迭代次数依赖秘密)、查表(内存地址依赖秘密)以及浮点运算(在大多数硬件上为可变时间)。ML-KEM 从第 15 章的中心二项分布中采样其小噪声多项式。 ML-DSA 对秘密和掩码使用其自身的有界均匀采样与拒绝采样过程;它并不是 ML-KEM 的 CBD 采样器的一个实例。两个标准都避免了通用的离散高斯采样器,但它们的采样接口和侧信道评审必须分别考虑。 FN-DSA(第 18 章)则是反面的警示。它的陷门采样器确实需要实数上的高精度高斯分布,并通过浮点 FFT 计算,而使这一点做到常数时间是所有标准中最困难的实现问题——如果采样器的计时或舍入发生泄露,秘密基就可能被重构出来。这一困难在第 18 章末尾已作预告,它正是本章的内容:这是 Falcon 成为三个签名标准中安全部署要求最高者的最有力的单一原因。
ML-DSA 中的拒绝采样。#
ML-DSA 签名(第 17 章)同样包含循环:它抽取一个掩码,构造 \(\mathbf{z}=\mathbf{y}+c\,\mathbf{s}_1\),并施加涉及依赖秘密之量的拒绝条件,包括与 \(\mathbf{s}_2\) 和 \(\mathbf{t}_0\) 相关的检查。因此,重试次数和签名时间不能仅凭对分布的直觉就被宣布为无害。实现必须遵循 FIPS 204 的采样与侧信道设计,保护中间值,并在目标平台上评估所生成的机器码。FIPS 204 支持对冲签名(hedged signing),其随机性由秘密 \(K\)、消息代表 \(\mu\) 和输入 \(rnd\) 导出;确定性模式固定了 \(rnd\),但并不会消除 \(K\) 或与秘密相关的拒绝条件。
解封装与 Fujisaki–Okamoto 变换。#
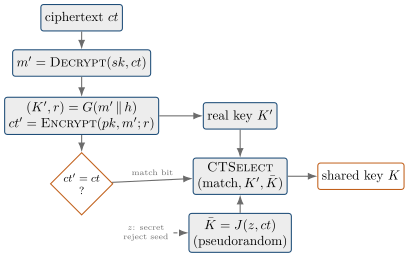
最隐蔽的 PQC 侧信道存在于 KEM 解封装之中。原始的格解密可能失败,而是否失败取决于秘密钥和(可能由攻击者选择的)密文。如果解封装在成功与失败时有任何不同的表现——返回一个错误、耗时更长或汲取不同的功率——攻击者就会获得一个解密失败预言机或明文检查预言机,通过查询畸形密文并利用是/否的回答来逐步剥离秘密。在第 16.13 节中阐述的 Fujisaki–Okamoto(FO)变换 [3]以隐式拒绝关上了这扇门。解封装对恢复出的消息重新加密,并以常数时间将结果与收到的密文进行比较。若匹配,则返回真实的共享密钥;若不匹配,则返回一个由秘密种子和密文导出的伪随机密钥——而不是一个可区分的密文有效性错误。这一点适用于基本的输入检查和解封装密钥检查之后;API 仍可能拒绝类型、长度畸形或不可用的密钥材料。两种密码学结果产生的密钥形式完全相同,最终的选择是一次常数时间选择,因此调用者无法分辨成功与失败。图 26.2 展示了这一流程。
NTT 与多项式运算。#
数论变换以及围绕它的模多项式运算,在每一次操作中都作用于秘密数据。它们同样必须是常数时间的:每次蝶形运算之后的模约简应使用固定开销的 Montgomery 约简或 Barrett 约简,而不是硬件除法,并且整个变换中任何地方都不得有依赖秘密的分支。这通常很容易做到——NTT 天然就是直线式的——但也很容易被一处粗心的条件减法所破坏,即只在“系数过大时”才执行的减法。
26.5常数时间之外的防护措施#
常数时间编码主要针对计时、缓存以及依赖秘密的控制流泄露。差分功耗分析和电磁分析更为强大,因为它们对大量迹线求平均,即使控制流完全一致,也能提取出影响功耗的秘密。要击败这些攻击,需要再加一层防护。
掩码。#
主要工具是掩码(masking):将每个秘密值拆分成若干个随机的份额,使其组合(对布尔掩码而言为 XOR,对算术掩码而言为模 \(q\) 加法)等于该秘密,并在份额上进行计算,使整个计算中没有任何单个中间值等于秘密或与秘密相关。一阶掩码使用两个份额,迫使攻击者同时组合两个位置的测量; \(d\) 阶掩码使用 \(d+1\) 个份额。安全性随 \(d\) 增长,代价也随之增长——份额数线性增长,而安全操作的数量及其消耗的新鲜随机性增长得更快,因此掩码的开销往往是数倍,有时达到一个数量级。对格方案而言,特有的困难在于它们混合了布尔运算(哈希、FO 检查中的比较)与算术运算(NTT),而在布尔掩码与算术掩码之间安全地转换,正是代价高昂且精细微妙的部分。
盲化。#
一个较轻量的近亲是盲化(blinding):在不改变结果的前提下随机化计算的表示,使得不同运行的迹线无法对齐。可以在运算前给某个值加上模数的随机倍数,在椭圆曲线运算步骤中随机化射影坐标,或者打乱处理各个独立系数的顺序,使攻击者无法知道迹线中的哪个采样点对应于哪个秘密元素。盲化比完整的掩码廉价,但也更弱;二者常常结合使用。
代价与收益。#
这些措施都不是免费的,也都不是总有必要的。位于网络之后、攻击者只能远程测量计时的服务器,需要常数时间代码,但很少需要完整的掩码。这里出现了一个限定条件:动态频率调节(Turbo Boost 及其同类技术)使时钟频率依赖于功耗,而功耗又依赖于被处理的数据——因此即便代码本身是常数时间的,功耗泄露也可能在远程 计时中显现,并且已有通过这一信道进行网络密钥提取攻击的演示 [4]。在威胁模型包含此类攻击的场合,为密码学工作负载禁用频率提升是直接的防护措施。而对于智能卡或嵌入式密钥存储,攻击者持有设备并能接上示波器,就还需要掩码和故障防护措施。恰当的防护级别是一个威胁模型层面的决策,而非固定的配方——但常数时间编码是这一切之下的底线。
26.6常见陷阱#
陷阱 1:假定编译器会保留你的常数时间代码。#
优化编译器只要认为更快,就可以自由地将 \((a \mathbin{\&} mask)\mathbin{|}(b \mathbin{\&}\overline{mask})\) 改写回分支或条件传送,或者让带掩码的比较短路求值。常数时间行为是所生成机器码的性质,而非源代码的性质。它必须经过检查——阅读汇编、使用验证工具,或使用阻止优化器的屏障——而不能想当然。
陷阱 2:将常数时间与恒定挂钟时间混为一谈。#
常数时间并不意味着代码总是运行相同的纳秒数。它意味着不存在依赖秘密的变化。仅依赖公开数据的变化——例如消息的长度——是完全可以接受的。追求字面意义上的恒定时长既无必要,在现代乱序执行的 CPU 上也不可能做到。
陷阱 3:报告解封装失败。#
在格解密失败时返回错误、记录日志或走一条快速路径,恰恰将 FO 变换旨在杜绝的明文检查预言机拱手交给了攻击者。解封装必须始终运行完毕并始终返回一个密钥;应使用隐式拒绝,绝不使用错误分支。
陷阱 4:用 memcmp 比较秘密。#
标准库的比较函数在找到一个不同字节时立即返回,因此其计时会暴露有多少个前导字节匹配——这对 MAC 标签或 FO 密文检查是致命的。务必使用不提前退出的比较,例如 ct_eq。
陷阱 5:仍然泄露的掩码。#
在纸面上正确的两个份额,如果硬件或编译器将它们重新组合,仍然会泄露——例如,连续的指令将两个份额写入同一个寄存器或总线,或者在应用掩码时没有为每次运行提供新鲜、独立的随机性。掩码的好坏,仅取决于其份额在实际硅片中的独立程度。
26.7小结#
前几章的后量子数学是真实可靠的:它能抵御 Shor 算法,并且针对其底层格问题与码问题,尚无已知的高效量子攻击。但这些数学只保护抽象的方案。一个粗心的实现可能把同一个秘密拱手交给一名手持示波器、共享缓存或激光的攻击者——这种攻击的代价是几分钟和几美元,而不是一台量子计算机。
防御是一种准则,而不是一件小工具:
编写常数时间代码——不使用依赖秘密的分支,不使用依赖秘密的内存地址,不在秘密上使用可变时间的指令;
在威胁模型包含物理接触的场合,再加上掩码和故障防护措施;
在所生成的机器码中验证这一性质,因为编译器并不承诺会保留它。
正是在这里,前面各部分的理论与实践形成了闭环。这些标准并没有把实现安全当作事后的补充;它们在工程上为之做了设计。 ML-KEM 的 CBD 采样器避免了通用的离散高斯分布(第 15 章);ML-DSA 和 FN-DSA 要求审慎处理依赖秘密的采样与拒绝条件(第 17 章、第 18 章);ML-KEM 解封装建立在隐式拒绝之上,使成功与失败不可区分(第 16 章);而 Falcon 的浮点采样器则是一个长久的提醒:当一个方案难以安全实现时,这种困难本身就是一种安全代价(第 18 章)。后量子安全不只是一个有待证明的定理。它是运行中系统的一种性质——而将它一路保持到机器码层面,并不是可有可无的。
评论