第 15 章中心二项分布(CBD)——为什么 Kyber 不使用高斯分布
15.1非常重要的一章#
在整个 Kyber 的故事中,本章是最容易被低估的章节之一。许多 Kyber 的入门介绍只说 CBD 不过是数几个比特而已。这话没错,但它忽略了更深层的要点。真正的故事是:CBD 并不只是一个方便的技巧。它是一项设计选择,把格密码、实现安全、硬件效率和标准化历史联系在一起。
核心问题很简单:
为什么 NIST 最终为 ML-KEM 选择了 CBD,而不是更传统的离散高斯分布?
读完本章,你应当能够解释:CBD 是什么,它为什么接近高斯分布,参数 \(\eta\) 的含义是什么,FIPS 203 的算法 2 如何运作,以及为什么 CBD 对常数时间实现如此有吸引力。
15.2回顾 LWE 的视角#
在 LWE 中,核心对象是噪声:
\[\mathbf{b}=A\mathbf{s}+\mathbf{e}.\]
安全性既不单独来自矩阵 \(A\),也不单独来自秘密 \(\mathbf{s}\)。关键要素是噪声向量 \(\mathbf{e}\)。
换言之,整个密码学困难性都系于这样一个事实:误差项以一种难以恢复的方式隐藏了秘密。因此,为该误差选择一个好的采样分布至关重要。
15.3高斯采样的主要问题#
在最初的理论性 LWE 构造中,人们通常使用离散高斯分布。样本取自如下形式的分布:
\[\Pr[X=x] \propto e^{-x^2/(2\sigma^2)}.\]
这在数学上很优雅,但从工程角度看却很棘手。
实际问题在于,高斯采样通常需要代价高昂的操作:
计算指数函数;
比较浮点数值;
拒绝采样;
反复循环,直到某个样本被接受。
这很慢,在软件中尤其如此。它也更难做到常数时间。
一个非常重要的副作用出现在实现安全方面。如果采样器使用拒绝循环和分支,运行时间就可能依赖于采样得到的值。这为计时攻击打开了大门:攻击者观察计时模式,试图推断出隐藏噪声的信息。
对于一个为现实部署而设计的密码系统来说,这是一个严重的缺陷。
15.4Kyber 的核心思想#
Kyber 并不试图以朴素的方式使用理想化的高斯分布。相反,它提出了一个更务实的问题:
能否构造一个看起来像高斯分布、却只由小整数、比特和简单算术构成的分布?
答案是肯定的,这个答案就是 CBD。
CBD 简单、只使用整数,并且对常数时间实现非常友好。与高斯采样器相比,它在硬件和软件上都容易部署得多。
15.5最简单的例子#
我们从最小的非平凡情形开始:\(\eta=2\)。
假设我们采样四个随机比特:
1010把它们分成两组,每组两个比特:
10 10数出每一半中 1 的个数:
前一半:\(10 \Rightarrow 1\)
后一半:\(10 \Rightarrow 1\)
然后相减:
\[1-1 = 0.\]
这就得到一个采样值。
再看另一个例子:
1110于是
前一半:\(11 \Rightarrow 2\)
后一半:\(10 \Rightarrow 1\)
因此
\[2-1 = 1.\]
最后,取
0011于是
前一半:\(00 \Rightarrow 0\)
后一半:\(11 \Rightarrow 2\)
所以
\[0-2 = -2.\]
由此,可能的取值为
\[-2,-1,0,1,2.\]
15.6为什么称为“中心”#
名称中的关键词是中心。
在大量样本中,正的结果与负的结果相互抵消。例如,\(-2\) 和 \(2\) 这样的值很少出现,而 \(0\) 最为常见。该分布以零为中心。
事实上,均值恰好为零,因为两半在期望意义下的贡献相等。
所以该分布以零为中心,而这正是 LWE 噪声所需要的。
15.7为什么它越来越像高斯分布#
其优美的数学原因在于,每个比特都表现为一个 Bernoulli 随机变量:
\[B_i \in \{0,1\}, \qquad \Pr(B_i=0)=\Pr(B_i=1)=\frac{1}{2}.\]
现在考虑许多这样的 Bernoulli 变量之和。由中心极限定理,许多独立 Bernoulli 变量之和近似服从高斯分布。
CBD 正是建立在这一现象之上的。它不是一种粗糙的启发式方法。它是一个在数学上接近高斯分布的离散分布,因为它由两个二项计数之差构成。
所以真正的逻辑是:
CBD 并不只是在试图看起来像高斯分布。它是一种离散构造,其形状自然地趋近于类高斯的钟形曲线。
15.8\(\eta\) 的含义是什么?#
参数 \(\eta\) 控制样本的大小。
若 \(\eta=2\),前一半使用两个比特,后一半也使用两个比特。
若 \(\eta=3\),每一半各使用三个比特。
一般地,我们定义
\[X = \sum_{i=1}^{\eta} B_i - \sum_{i=\eta+1}^{2\eta} B_i,\]
其中每个 \(B_i\) 都是一个随机比特。
所得的取值范围为
\[-\eta, -\eta+1, \dots, \eta.\]
因此,\(\eta\) 越大,噪声幅度越大,分布也就越宽。
15.9ML-KEM 的实际参数选择#
在实际的 ML-KEM 参数集中,\(\eta_1\) 和 \(\eta_2\) 的取值并非随意。它们是根据安全性和解密失败率的要求来选取的。
| 参数集 | \(\eta_1\) | \(\eta_2\) |
|---|---|---|
| ML-KEM-512 | 3 | 2 |
| ML-KEM-768 | 2 | 2 |
| ML-KEM-1024 | 2 | 2 |
这里 \(\eta_1\) 通常用于秘密的分布,而 \(\eta_2\) 用于加密噪声。
重要的是,这些选择并不是简单的越大越安全。它们经过精心调校,以在安全性、正确性和实现效率之间取得平衡。
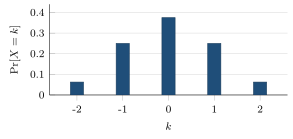
图 15.1 绘出了上表中实际出现的两个 \(\eta\) 值所对应的精确概率质量函数,直接由 \(\Pr[\mathrm{CBD}(\eta)=k]=\binom{2\eta}{\eta+k}/4^{\eta}\) 计算得到。
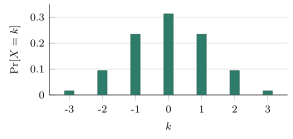
15.10FIPS 203 算法 2:发生了什么?#
在 FIPS 203 中,标准描述了一个采样过程,它本质上就是 CBD 采样操作。
其高层流程非常简单:
输入一个长度为 \(2\eta\) 的比特串;
将其分成两组,每组长度为 \(\eta\);
数出每组中 1 的个数;
将两个计数相减。
所以这个过程实际上就是:
\[\text{CBD}_{\eta}(x) = \sum_{i=0}^{\eta-1} x_i - \sum_{i=\eta}^{2\eta-1} x_i.\]
通俗地说:一个短的输入比特串被转换为一个小的有符号整数噪声样本。
这正是 Kyber 在实际实现中所依赖的操作。
如果用精确的比特下标、而不是上面“分成两组”这种非正式描述来精确地写出来,这就是 FIPS 203 的算法 2,即 SamplePolyCBD\(_\eta\)。它并不是每次从一个新的比特串中采样一个系数;而是消耗一个长度为 \(64\eta\) 字节的长字节数组 \(B\),并把它切分成 \(256\) 个互不重叠的窗口,每个窗口 \(2\eta\) 比特,每个输出系数对应一个窗口。
因此,每个系数 \(f_i\) 读取 \(b\) 中属于它自己的一段 \(2\eta\) 比特切片,起始比特偏移为 \(2i\eta\):切片的前 \(\eta\) 个比特计入 \(x\),接下来的 \(\eta\) 个比特计入 \(y\),并且 \(f_i=x-y \bmod q\)。对于 \(i=0\),这恰好就是上面手工演算过的“前一半、后一半、相减”的做法;唯一新增的内容是显式的偏移量 \(2i\eta\),它对 \(256\) 个系数中的每一个都精确指明了 \(64\eta\) 字节数组中哪些比特属于它。
15.11一个简单的 Sage 实现#
下面是一个非常小的 Python 版本。
from random import randint


def cbd(eta):
    a = 0
    b = 0

    for _ in range(eta):
        a += randint(0, 1)

    for _ in range(eta):
        b += randint(0, 1)

    return a - b
一个快速测试如下:
for _ in range(20):
    print(cbd(2))
典型的输出可能是
0
1
-1
0
2
-215.12直方图视角#
要真正理解 CBD,应当看一看它的直方图。
samples = [cbd(2) for _ in range(100000)]该分布趋向于集中在零附近,并且越来越呈钟形。这正是它常被描述为高斯分布的离散近似的原因。
用 matplotlib 可以做一个非常简单的可视化:
from collections import Counter
import matplotlib.pyplot as plt

samples = [cbd(2) for _ in range(100000)]
cnt = Counter(samples)

plt.bar(cnt.keys(), cnt.values())
plt.show()
如果分别尝试 \(\eta=2\)、\(\eta=3\) 和 \(\eta=4\),就可以看到形状变得更平滑、更对称。
15.13为什么标准不使用 randint#
一个微妙但重要的问题是,真正的 FIPS 实现并不会照字面使用 Python 中 randint(0, 1) 这类调用。
相反,标准通过诸如 SHAKE 这样的可扩展输出函数,从种子进行确定性扩展。
也就是说,种子被确定性地扩展:SHAKE 把它变成一个伪随机比特流,CBD 再把这些比特变成噪声样本。完整的流水线见第 15.16 节。这一设计使噪声可以由种子复现,并且便于集成到更大的协议之中。
15.14为什么 CBD 对常数时间友好#
CBD 最大的实际优势之一,是它很容易以常数时间实现。
所涉及的操作只有:
比特计数;
加法;
减法。
在基本流程中,既没有代价高昂的拒绝循环,也没有依赖数据的 if 分支。
这使得 CBD 比带有拒绝步骤的高斯采样器更容易防御计时攻击。
15.15对玩具版 Kyber 代码的一个小升级#
如果我们之前写过一个用简单例程生成小值的玩具版采样器,那么现在就可以把它替换为 CBD 式的采样。
例如,我们可以写成这样:
def small_poly(n):
    coeff = []
    for _ in range(n):
        coeff.append(cbd(2))
    return coeff
这样一来,玩具版 Kyber 代码就更接近实际的 ML-KEM 设计了。
15.16FIPS 203 中完整的噪声流水线#
现在我们可以把 FIPS 203 中噪声所经历的完整路径拼接起来:从初始种子一直到一个模 LWE 样本。

因此,噪声并不是什么神秘的浮点对象。它是一个小整数,通过安全的扩展过程由种子确定性地导出,并且沿途的每一步都是可复现的、常数时间的——这正是一个标准所要求的。
15.17小结#
本章的重要教训是:CBD 不只是一个方便的技巧。它是一种非常实用的采样方法,兼具四个有用的性质:
它的形状近似于高斯分布。
它易于实现。
它容易做到常数时间。
它非常适合软件和硬件部署。
这就是为什么 CBD 成为 ML-KEM 中的标准选择,而不是理论上更为传统的高斯采样器。
一句话概括:
CBD 提供了一个对基于格的安全性而言足够好的噪声分布,它易于实现,而且比高斯采样更容易防御侧信道攻击。
15.18下一步建议#
接下来自然的话题是内部的哈希与扩展层:为什么 SHAKE 和 Keccak 如此强大,以及一个短种子如何生成大量伪随机材料。这是从 CBD 通往实际 FIPS 203 和 FIPS 204 实现的桥梁。
评论