第 3 章线性代数基础
3.1本章为何重要#
本章并不是一门通用的线性代数课程。它的目的是以足以在后文派上用场的精确程度,阐述后量子密码赖以建立的那些特定结构:有限域上的向量空间、线性映射及其矩阵,以及决定线性方程组何时可解的秩–零化度关系。格密码的核心对象是方程 \[A\mathbf{s} + \mathbf{e} = \mathbf{b},\] 它是一个被小误差 \(\mathbf{e}\) 故意扰动的线性方程组。要理解为什么未扰动的方程组容易求解,而扰动后的方程组(据推测)是困难的,我们首先需要精确地说明“求解线性方程组”是什么意思。
3.2学习目标#
读完本章后,你应当能够:
陈述向量空间的公理,并认识到 \(\mathbb{F}_q^n\) 是我们的工作范例;
定义线性无关、张成、基和维数,并知道为什么维数是良定义的;
将矩阵描述为线性映射的坐标形式,并定义其秩、核与像;
陈述秩–零化度定理,并用它来推理 \(A\mathbf{x}=\mathbf{b}\) 的可解性;
精确解释为什么 \(A\mathbf{s}=\mathbf{b}\) 是容易的,而 \(A\mathbf{s}+\mathbf{e}=\mathbf{b}\) 却是困难的 LWE 问题。
3.3标量:底层的域#
每个向量空间都建立在一组可以进行加、减、乘、除运算的标量之上。这组标量构成一个域(见第 2 章,那里介绍了有限域 \(\mathbb{F}_q = \mathrm{GF}(q)\))。由于本章其余部分都依赖于这一定义,我们在此重述一遍。
定义 3.1 (域). 域是一个带有两种运算 \(+\) 和 \(\cdot\) 的集合 \(\mathbb{F}\),使得 \((\mathbb{F},+)\) 是以 \(0\) 为单位元的阿贝尔群,非零元素 \((\mathbb{F}\setminus\{0\},\cdot)\) 构成以 \(1\) 为单位元的阿贝尔群,并且乘法对加法满足分配律。特别地,每个非零元素都有乘法逆元。
我们熟悉的域有 \(\mathbb{Q}\)、\(\mathbb{R}\) 和 \(\mathbb{C}\)。密码学则是在有限域 \(\mathbb{F}_q\) 上进行运算;当 \(q\) 为素数时,它就是模 \(q\) 的整数, \[\mathbb{F}_q = \mathbb{Z}/q\mathbb{Z} = \{0,1,\dots,q-1\},\] 其算术运算均模 \(q\) 约简。使它成为域而不仅仅是环的性质在于可以做除法:由于 \(q\) 是素数,每个非零剩余都有逆元。正是这一点使高斯消元得以进行,这也是为什么诸如 \(q=3329\)(Kyber)这样的密码参数要选为素数。
3.4向量与向量空间#
在中学里,向量是一个坐标元组,例如 \((1,2)\)。就我们的目的而言,向量是向量空间中的一个元素:一种由域元素构成、可以相加和数乘的结构化容器。
定义 3.2 (向量空间). 域 \(\mathbb{F}\) 上的向量空间是一个集合 \(V\),它带有加法 \(V\times V\to V\) 和数乘 \(\mathbb{F}\times V\to V\),使得 \((V,+)\) 是阿贝尔群,并且对所有 \(a,b\in\mathbb{F}\) 及 \(\mathbf{u},\mathbf{v}\in V\),有 \[a(\mathbf{u}+\mathbf{v}) = a\mathbf{u}+a\mathbf{v},\quad (a+b)\mathbf{v} = a\mathbf{v}+b\mathbf{v},\quad (ab)\mathbf{v} = a(b\mathbf{v}),\quad 1\mathbf{v} = \mathbf{v}.\]
例 3.3 (空间 \(\mathbb{F}_q^n\)). 列向量的集合 \[\mathbb{F}_q^n = \left\{ (v_1,\dots,v_n)^\top : v_i \in \mathbb{F}_q \right\},\] 在逐分量加法和数乘下,构成 \(\mathbb{F}_q\) 上的向量空间。它是有限的:恰好包含 \(q^n\) 个元素。Kyber 的秘密钥位于 \(\mathbb{F}_{3329}^{256}\) 中,因此它是 \(3329^{256}\) 个可能向量之一——这已经远远超过可观测宇宙中的原子数目。
一个典型的秘密写作 \[\mathbf{s} = \begin{bmatrix}2\\5\\1\\7\end{bmatrix} \in \mathbb{F}_{q}^{4}, \qquad\text{or in practice}\qquad \mathbf{s} \in \mathbb{F}_{3329}^{256}.\]
3.4.1Sage 实验:创建向量#
F = GF(17)
v = vector(F, [1, 2, 3])
v
要查看它的类型,可使用 type(v)。Sage 报告它是一个自由模元素,而非普通列表。这并非吹毛求疵:域上的向量空间是环上模的特例,即该环恰好是一个域的情形;而模 LWE(第 13 章)所用的正是这种更一般的对象。
3.4.2向量加法与数乘#
a = vector(F, [1, 2, 3])
b = vector(F, [5, 6, 7])
a + b        # (6, 8, 10)
3 * a        # (3, 6, 9)
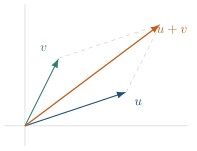
所有算术运算都模域的特征进行:在 \(\mathbb{F}_7\) 上,和 \(6+5\) 等于 \(4\) 而非 \(11\)。在 \(\mathbb{R}\) 或 \(\mathbb{Q}\) 上,加法具有图 3.1所示的熟悉的平行四边形图景。
3.5线性组合、线性无关与张成#
整个学科中最重要的单一运算,就是构造线性组合。
定义 3.4 (线性组合与张成). 给定向量 \(\mathbf{v}_1,\dots,\mathbf{v}_k \in V\) 和标量 \(c_1,\dots,c_k\in\mathbb{F}\),向量 \(\sum_{i=1}^k c_i\mathbf{v}_i\) 称为这些 \(\mathbf{v}_i\) 的一个线性组合。所有这样的组合构成的集合称为它们的张成,记作 \(\mathrm{span}(\mathbf{v}_1,\dots,\mathbf{v}_k)\);它是 \(V\) 中包含每个 \(\mathbf{v}_i\) 的最小子空间。
定义 3.5 (线性无关). 若等于零向量的线性组合只有平凡组合,则称向量 \(\mathbf{v}_1,\dots,\mathbf{v}_k\) 线性无关: \[\sum_{i=1}^k c_i \mathbf{v}_i = \mathbf{0} \quad\Longrightarrow\quad c_1 = \cdots = c_k = 0.\] 否则称它们线性相关,这意味着其中某一个是其余向量的线性组合。
例如,\((1,0)\) 与 \((0,1)\) 线性无关,而 \((1,2)\) 与 \((2,4)\) 线性相关,因为后者是前者的两倍。
3.5.1Sage 实验:通过秩检测线性相关#
线性相关可以借助秩(下文给出精确定义)在数值上检测:将这些向量作为行堆叠起来,秩就统计了其中真正线性无关的向量个数。
A = Matrix(GF(17), [[1, 2], [2, 4]])
A.rank() # 1: only one independent direction3.6基与维数#
定义 3.6 (基). 向量空间 \(V\) 的一组基是一个既线性无关又张成 \(V\) 的向量集合。等价地,每个 \(\mathbf{v}\in V\) 都可以唯一地表示为基向量的线性组合。
\(\mathbb{F}_q^2\) 的标准基是 \(\{(1,0),(0,1)\}\),因为 \((a,b)=a(1,0)+b(0,1)\)。但 \(\{(2,1),(1,1)\}\) 同样是该空间的一组合法的基:空间是内在的,而基是为它选取的一个坐标系。基中向量的个数则不是可以选择的。
定理 3.7 (维数是良定义的). 有限维向量空间 \(V\) 的任意两组基所含元素个数相同。这个公共的数称为维数 \(\dim V\)。
因此 \(\dim \mathbb{F}_q^n = n\)。可以在不改变空间的情况下自由更换基,这正是整个格基约化理论的萌芽(第 8 章):格同样有许多组基,而找到一组好的基,是核心的算法问题。
3.6.1Sage 实验:同一空间的两组基#
B1 = Matrix(GF(17), [[1, 0], [0, 1]])
B2 = Matrix(GF(17), [[2, 1], [1, 1]])
# both have rank 2, so each is a basis of GF(17)^2
print(B1.rank(), B2.rank())3.7作为线性映射的矩阵#
理解矩阵的最佳方式,不是把它看作一张数字网格,而是把它看作线性映射的坐标形式。
定义 3.8 (线性映射). 若映射 \(T\colon \mathbb{F}^n \to \mathbb{F}^m\) 保持两种运算,则称它是线性的: \[T(\mathbf{u}+\mathbf{v}) = T(\mathbf{u})+T(\mathbf{v}),\qquad T(a\mathbf{v}) = a\,T(\mathbf{v}).\] 一旦取定了基,每个线性映射都由一个 \(m\times n\) 矩阵 \(A\) 通过 \(T(\mathbf{v})=A\mathbf{v}\) 给出,而每个这样的矩阵也都定义了一个线性映射。
乘积 \(A\mathbf{v}\) 本身就是一个线性组合:它是以 \(\mathbf{v}\) 的各分量为权重、对 \(A\) 的各列所作的组合。具体地说,结果的第 \(i\) 个分量是 \(A\) 的第 \(i\) 行与 \(\mathbf{v}\) 的内积,这恰好就是算法 2中的双重循环。
F = GF(17)
A = Matrix(F, [[1, 2], [3, 4]])
v = vector(F, [5, 6])
A * v这同一个循环是全书的基础:它计算 LWE 方程中的 \(A\mathbf{s}\);而在环的形式下(第 12 章),它又以 RLWE 和 Kyber 所使用的教科书式多项式乘法的面貌重新出现。
3.8秩、核与像#
有三个子空间刻画了线性映射 \(A\colon\mathbb{F}^n\to\mathbb{F}^m\) 的作用。
定义 3.9 (像、核、秩). 像(或列空间)是 \(\operatorname{im}A = \{A\mathbf{v} : \mathbf{v}\in\mathbb{F}^n\}\subseteq\mathbb{F}^m\);其维数称为 \(A\) 的秩。核(或零空间)是 \(\ker A = \{\mathbf{v}\in\mathbb{F}^n : A\mathbf{v}=\mathbf{0}\}\subseteq\mathbb{F}^n\);其维数称为零化度。
像恰好是使 \(A\mathbf{x}=\mathbf{b}\) 有解的所有右端项 \(\mathbf{b}\) 构成的集合。核则衡量解偏离唯一性的程度:若 \(A\mathbf{x}_0=\mathbf{b}\),则全部解构成的集合为 \(\mathbf{x}_0 + \ker A\)。这两个维数是相互关联的。
定理 3.10 (秩–零化度定理). 对任意线性映射 \(A\colon \mathbb{F}^n \to \mathbb{F}^m\),有 \[\dim(\ker A) + \operatorname{rank}(A) = n.\]
特别地,方阵 \(A\in\mathbb{F}^{n\times n}\) 可逆,当且仅当其秩为 \(n\),等价地 \(\ker A=\{\mathbf{0}\}\),又等价地其各列构成 \(\mathbb{F}^n\) 的一组基。当 \(A\) 可逆时,对每个 \(\mathbf{b}\),\(A\mathbf{x}=\mathbf{b}\) 都恰有一个解。
3.8.1Sage 实验:秩决定可逆性#
F = GF(17)
for _ in range(10):
    A = random_matrix(F, 4, 4)
    print(A.rank())
对于 \(\mathbb{F}_q\) 上均匀随机的 \(n\times n\) 矩阵,其可逆的概率为 \[\prod_{i=1}^{n}(1-q^{-i}).\] 因此上述论断依赖于 \(q\):对于这个 \(\mathbb{F}_{17}\) 上的 \(4\times4\) 示例,该概率很高,而在 \(\mathbb{F}_2\) 上则只有约 \(30.8\%\)。
3.9求解线性方程组,以及向 LWE 的跨越#
给定 \(A\) 和 \(\mathbf{b}\),方程 \(A\mathbf{x}=\mathbf{b}\) 可用高斯消元求解:通过行变换将 \(A\) 化为阶梯形,再经回代求出 \(\mathbf{x}\)。
命题 3.11 (线性方程组是容易的). 在域上,高斯消元使用 \(O(n^3)\) 次域运算即可求解 \(n\times n\) 方程组 \(A\mathbf{x}=\mathbf{b}\)(或报告无解)。若 \(A\) 可逆,则解唯一。
正是这种高效性,使得普通的线性方程组毫无密码学价值:任何看到 \(A\) 和 \(\mathbf{b}=A\mathbf{s}\) 的人都能在立方时间内恢复秘密 \(\mathbf{s}\)。LWE 改变了这一情形。给定一个公开的、通常为长方形的随机矩阵 \(A\in\mathbb{Z}_q^{m\times n}\)(其中 \(m>n\))、一个从规定的小分布中抽取的秘密 \(\mathbf{s}\),以及一个独立的小误差向量 \(\mathbf{e}\),人们观察到的样本为 \[\mathbf{b} = A\mathbf{s} + \mathbf{e},\] 其算术运算模 \(q\) 进行。与可逆的方阵方程组不同,对于非零的随机误差,这个超定方程组一般没有精确解。高斯消元可以检测出不相容性,但无法从含噪样本中恢复植入的秘密。恢复 \(\mathbf{s}\) 就是带误差学习(Learning With Errors)问题(第 11 章)。
注 1.1. 值得停下来体会一下:纸面上的变化如此之小,难度上的变化却如此之大。对于可逆方阵,\(\mathbf{s}\mapsto A\mathbf{s}\) 很容易求逆。而在有许多含噪样本时,观察到的值还依赖于独立采样的误差;密码学上的困难性就在于区分和利用这种结构。
3.10实验#
F = GF(17)
# 1. random vectors
V = VectorSpace(F, 4)
for _ in range(5): print(V.random_element())

# 2. a matrix acting on a vector
A = random_matrix(F, 6, 4); v = random_vector(F, 4)
print(A * v)

# 3. exact solve is easy; try recovering s from b = A*s
s = random_vector(F, 4); b = A * s
print(A.solve_right(b) == s)   # True when A has full column rank

# 4. perturb an overdetermined system: it normally becomes inconsistent
e = vector(F, [1, 0, 0, 16, 0, 0])   # 16 == -1 mod 17
try:
    A.solve_right(b + e)
except ValueError:
    print("no exact solution: noisy samples are inconsistent")
该实验只是一个玩具版的示意:真正的 LWE 会精确规定维数以及秘密和误差的分布。
3.11与下一章的联系#
下一章多项式环保留了线性代数的视角,但把“标量与向量”的图景改换为一个更丰富的单一对象。一个结构化的(循环)矩阵将由一个多项式来编码,矩阵–向量乘法将变为多项式乘法,而向量空间 \(\mathbb{F}_q^n\) 将升级为商环 \[R_q = \mathbb{Z}_q[x]/(x^n + 1),\] 这正是 RLWE 和 Kyber 的天然归宿。
评论