第 16 章ML-KEM(FIPS 203)的完整实现
16.1学习目标#
本章把本书前面构建的各个部件——负循环环与 NTT(第 6 章)、玩具版方案(第 14 章)以及中心二项采样(第 15 章)——组装成真正的标准。FIPS 203,即 ML-KEM(源自提交方案 CRYSTALS-Kyber) [1, 2],是基于模格的密钥封装标准,也是 NIST 后量子标准中第一个定稿的(2024 年)。本章中所有算法与数据流的细节均遵循 FIPS 203 [1]。
学完本章后,你应当能够:
跟随完整的 ML-KEM 密钥生成流程,并了解其每个阶段的数据类型;
解释为什么一旦初始种子固定,密钥生成几乎完全是确定性的;
跟随封装过程,并解释为什么 KEM 封装的是一个随机秘密,而不是加密选定的数据;
跟随解封装过程,并解释带隐式拒绝的 Fujisaki–Okamoto “重加密并比较”变换;
区分 CPA 安全的内层方案(K-PKE)与构建于其上的 CCA 安全 KEM(ML-KEM)。
16.2回顾:玩具版 Kyber 与真正的 ML-KEM#
在第 14 章的玩具版实现中,我们使用了如下非正式的密钥生成模式:
\[A \xleftarrow{\$} R_q^{k\times k}, \qquad s,e \xleftarrow{\$} \chi, \qquad t = A\cdot s + e.\]
输出则是一个密钥对 \((pk, sk)\)。
最重要的区别在于,那里所有随机对象都是直接且独立地生成的。
在真正的 ML-KEM 中并非如此。算法从一个短的随机种子出发,然后由它确定性地扩展出其余所有随机性。
16.3FIPS 203 中的真实输入#
标准的密钥生成过程并不是从随机生成一个矩阵开始的。它从生成一个短的随机种子开始:
\[d \in \{0,1\}^{256}.\]
换言之,标准算法的输入是一个 256 比特的种子。我们可以把整个密钥生成算法看作一个确定性函数
\[\mathrm{KeyGen}(d)\]
而不是一个独立地采样所有对象的随机过程。
这是从玩具版 Kyber 到真正标准的第一个重大观念转变。
16.4阶段 1:扩展种子#
标准中的第一步是计算
\[(\rho, \sigma) = G(d),\]
其中:
\(\rho\) 用于生成矩阵 \(A\);
\(\sigma\) 用于生成秘密多项式和误差多项式。
在标准中,\(G\) 由 SHA3-512 构建。在教学实现中,我们可以先把它抽象为一个黑盒:
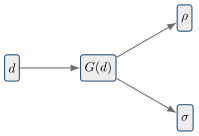
从教学角度看,要点在于后续各步骤的全部随机性都源自初始种子 \(d\)。
16.5阶段 2:生成矩阵#
矩阵并不作为随机对象存储在公钥中。相反,它由一个种子重构出来:
\[A = \mathrm{ExpandA}(\rho).\]
这是一个确定性映射:
\[\mathrm{ExpandA}: \{0,1\}^{256} \to R_q^{k\times k}.\]
相同的种子总是产生相同的矩阵。这是标准中一个至关重要的压缩技巧。
SageMath 实验#
对于教学实现,我们可以先用一个简单的确定性伪随机生成器来模拟这种扩展。
from random import Random
from sage.all import GF, Matrix, PolynomialRing

q = 17
n = 8
k = 2
R.<x> = PolynomialRing(GF(q))
Rq = R.quotient(x^n + 1)


def expand_A(seed):
    rng = Random(str(seed))
    return Matrix(
        Rq,
        k,
        k,
        [Rq([rng.randrange(q) for _ in range(n)])
         for _ in range(k * k)]
    )
在这一阶段,重要的不是具体的随机源,而是接口:
相同种子 \(\Rightarrow\) 相同矩阵;
不同种子 \(\Rightarrow\) 不同矩阵。
16.6阶段 3:生成秘密向量#
秘密向量由 CBD 分布导出。换言之,
\[s \leftarrow \mathrm{CBD}(\sigma).\]
这不是均匀采样。其系数是从中心二项分布中采样得到的小整数。因此,秘密多项式的每个系数都是一个小的有符号值,而不是环中的任意元素。
于是,秘密向量是一个由小多项式组成的向量:
\[s = (s_0, \dots, s_{k-1}).\]
16.7阶段 4:生成误差向量#
误差向量以非常类似的方式生成,同样使用基于 CBD 的采样:
\[e \leftarrow \mathrm{CBD}(\sigma).\]
具体细节取决于参数集,但概念要点是相同的:噪声是通过确定性采样过程由一个短种子导出的。
16.8阶段 5:在 NTT 域中计算公钥#
FIPS 203 以系数形式采样秘密和误差,然后再对它们进行变换。ExpandA 直接以 NTT 表示生成矩阵。公开向量的计算方式为 \[\hat t=\hat A\circ\hat s+\hat e,\] 其中 \(\circ\) 使用规定的 MultiplyNTTs 运算:即 128 个二次基乘积,而不是不加限制的逐坐标标量乘法。PKE 公钥编码 \((\hat t,\rho)\),PKE 秘密钥编码 \(\hat s\);在之后需要系数域值的地方再使用逆 NTT。这就是 FIPS 203 第 4.3.1 节和第 5.1 节中的数据流。
16.9阶段 7:编码公钥#
真正的公钥并不是二元组 \((A,t)\)。相反,它本质上是二元组
\[(\rho, t).\]
原因在于矩阵 \(A\) 可以由种子 \(\rho\) 重新生成。因此,公钥只存储真正必要的内容:
种子 \(\rho\);
向量 \(t\)。
16.10KeyGen 的数据流#
整个过程可以概括如下:
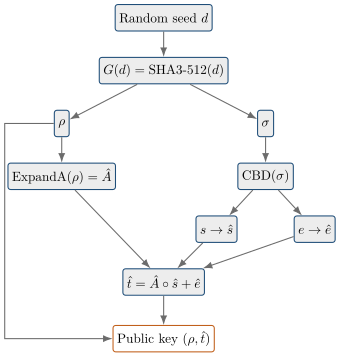
这个流程应当牢记,因为它会在下文的封装和解封装中再次出现。写成伪代码,上面的七个阶段可以压缩为一个简短的算法:
给定 \(d\) 后,这里的每一行都是确定性的;在整个计算中,新鲜随机性唯一进入的地方就是对 \(d\) 本身的采样。
16.11从 K-PKE 到 ML-KEM:两个层次#
上面的算法还不完全是 ML-KEM。它是 K-PKE 的密钥生成,K-PKE 是底层的公钥加密方案,它仅是CPA 安全的——能抵御被动窃听者,但不能抵御提交选定密文并观察解密如何响应的攻击者。ML-KEM 就是在 K-PKE 外面再包一层。K-PKE 提供三个例程, \[\text{K-PKE.K}{\small\text{EY}}\text{G}{\small\text{EN}},\qquad \text{K-PKE.E}{\small\text{NCRYPT}}(ek, m, r),\qquad \text{K-PKE.D}{\small\text{ECRYPT}}(dk, c),\] 而 Fujisaki–Okamoto(FO)变换 [3] 把它们转化为一个CCA 安全的密钥封装机制。ML-KEM 的密钥生成只是调用 K-PKE 的密钥生成,并在秘密钥中多存储一点内容:
封装密钥 \(ek=(\rho,t)\) 是 KEM 所公开的内容。解封装密钥包含 PKE 秘密 \(dk_{\mathrm{PKE}}=s\)、\(ek\) 的一份副本及其哈希 \(H(ek)\)(二者在解封装期间重加密时都需要),以及随机值 \(z\),其作用将在下文中变得清楚。
16.12封装#
封装产生一个新鲜的共享秘密 \(K\) 和一个密文 \(c\),持有 \(dk\) 的一方可以从中恢复出同一个 \(K\)。定义 KEM 的设计选择——也是对“为什么封装一个随机秘密,而不是加密一条选定的消息?”这一问题的回答——在于被加密的消息根本不由发送方选择。封装过程采样一个随机的 \(32\) 字节值 \(m\),并通过对其哈希同时导出共享密钥和加密随机性。随机性是消息的确定性函数,这正是 FO 变换将要利用的性质。
在 \(\text{K-PKE.E}{\small\text{NCRYPT}}\) 内部,消息以与第 14 章玩具版方案相同的含噪线性方式被隐藏,只是现在由种子 \(r\) 驱动:矩阵被重新生成为 \(A=\text{E}{\small\text{XPAND}}\text{A}(\rho)\),小向量 \(y,e_1,e_2\) 使用 \(r\) 从 CBD 中采样,而密文是经过压缩的二元组 \[u = A^{T} y + e_1, \qquad v = t^{T} y + e_2 + \mathrm{Encode}(m).\] 共享秘密 \(K\) 本身从不在线路上传输;传输的只有 \(c\),接收方从中重构出 \(K\)。
16.13从 CPA 到 CCA:Fujisaki–Okamoto 变换#
到目前为止构建的一切——第 14 章的玩具版方案、第 15 章的真实噪声,以及上面的 K-PKE——都是仅能抵御被动窃听者的公钥加密方案。在其中任何一个可以安全部署之前,还需要再加一层,而 FIPS 203 直言这一层并非可选:K-PKE “不是 IND-CCA2 安全的,不得作为独立方案使用” [1]。本节解释所缺失的性质是什么,以及 Fujisaki–Okamoto(FO)变换如何提供它。同一变换会在本书的其他每个 KEM 中再次出现——Classic McEliece(第 22 章)、HQC(第 23 章)和 SIKE(第 25 章)——因此值得认真地认识一次。
两种攻击模型。#
加密的各种安全概念之间的区别在于攻击者可以做什么,而不在于他们试图获知什么。在这两种概念下,攻击者都选择两条消息,得到其中一条的加密,并且必须判断是哪一条:
IND-CPA——选择明文攻击下的不可区分性。攻击者持有公钥,因而可以加密任何想加密的内容。这刻画了被动窃听者。
IND-CCA2——适应性选择密文攻击下的不可区分性。攻击者还可以把自己构造的密文提交给诚实的密钥持有者并观察结果,在看到挑战密文之前和之后都可以这样做;唯一禁止的是解密挑战密文本身。
二者之间的差距,就是一个只会监听的攻击者与一个能够交互的攻击者之间的差距。现实中的协议几乎按定义就授予了第二种访问能力:服务器会解密线路上到达的任何内容,而它接下来的行为——一个错误、一个时间差异、一次重试——对发送者都是可见的。
为什么被动安全的方案会被攻破。#
这种失败是具体的,而非理论上的。K-PKE 密文是一个二元组 \((\mathbf{u}, v)\),其中消息比特由 \(v\) 携带,每个比特乘以 \(\lceil q/2 \rceil\)。运算是逐坐标进行的,因此截获 \((\mathbf{u}, v)\) 并转发 \((\mathbf{u},\ v + \lceil q/2 \rceil)\) 的攻击者,会交给接收方一个完全有效的密文,其解密结果是原消息的补——而攻击者既不知道秘密钥,也从未得知消息本身。这就是可延展性:密文可以被编辑成相关的密文。使格加密快速的线性性,恰恰也是使其可延展的原因。
解密预言机同样会泄露信息。向密钥持有者输入一连串略有畸形的密文,并记录哪些能被正常解密;每个回答都是约束秘密的一个不等式,足够多的回答就能恢复秘密。这就是为什么被动安全的格方案绝不能被直接暴露。
核心思想:使加密确定化。#
可延展性之所以能够存在,只是因为密文不带有任何关于其构造方式的证据。加密是随机化的——对新鲜随机的 \(r\) 计算 \(\text{E}{\small\text{NCRYPT}}(ek, m; r)\)——因此一条消息有许多有效密文,接收方无法区分诚实的密文与被篡改的密文。
FO 消除了这种自由度。不再采样 \(r\),而是从消息中导出它:\(r = G(m)\)。加密于是只是消息的函数,因此每条消息现在恰好只有一个有效密文——这使得密文变得可校验。接收方解密得到候选消息 \(m'\),重新计算 \(m'\) 必然会产生的密文,并进行比较。诚实的密文能够匹配;攻击者改动过的任何内容都不能。
KEM 的场景使得这一点毫无代价。由于 KEM 传输的是一个随机秘密而不是选定的消息(第 14 章),从消息导出随机性不会损失任何东西——消息本身从来就不是重点。封装过程采样一个随机的 \(m\),并把它哈希为共享密钥和加密随机性两者,这正是算法 18 用 \((K, r) \gets G(m \,\|\, h)\) 所做的事情。
分两步完成的变换。#
现代的表述源自 Hofheinz、Hövelmanns 和 Kiltz [4],并被 FIPS 203 本身所引用,它把 FO 拆分为两个相互独立的部分:
\(T\) 变换负责去随机化,把一个 IND-CPA 加密方案变为一个确定性方案,其密文可以通过重加密来验证;
\(U\) 变换把该确定性方案包装为一个 KEM,通过哈希导出共享秘密,并决定当重加密检查失败时该怎么做。
把二者分开,使得安全性证明可以由各部分拼装而成,这也是为什么文献中谈论的是一族 FO 变体,而不是单个算法。ML-KEM 使用的是这一族中的一个特定成员,下一节将详细说明。
16.14解封装与 Fujisaki–Okamoto 变换#
解封装必须利用 \(dk\) 从 \(c\) 中恢复 \(K\),并且——这正是 FO 变换的全部意义所在——必须以这样一种方式完成:攻击者提交畸形密文时得不到任何可利用的信号。其机制是重加密并比较:解密得到候选消息,由它确定性地重新运行封装,并检查本应产生的密文是否与收到的密文一致。
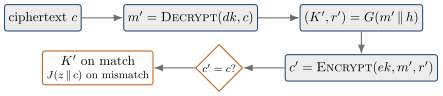
微妙之处在于 else 分支。一个朴素的 KEM 会在遇到坏密文时返回一个错误——但这个错误就是一个预言机:通过观察解封装是否成功,攻击者可以发起选择密文攻击,并在多次查询之后提取出秘密。隐式拒绝堵住了这扇门:当不匹配时,ML-KEM 返回一个由秘密 \(z\) 导出的伪随机密钥 \(J(z\,\|\,c)\),其形式与真实密钥完全相同。对调用者而言,成功与失败变得无法区分,因此不存在预言机。正是这一点把 K-PKE 从 CPA 安全提升到 IND-CCA2 安全;这也是为什么比较 \(c'=c\) 必须以常数时间执行(第 26 章);并且这与基于编码的 KEM HQC 所使用的机制相同(第 23 章)。
显式拒绝与隐式拒绝。#
处理比较失败的两种方式,命名了 FO 族的两个分支。显式拒绝返回一个特殊的错误符号 \(\bot\);隐式拒绝则像 ML-KEM 那样返回一个伪随机密钥。隐式拒绝在三个方面是更保守的选择:它彻底消除了错误信号,而不是寄希望于每个调用者都能安全地处理 \(\bot\);它使解封装保持为一个单一的直线式计算,这要容易做成常数时间得多;并且,针对量子敌手的最紧安全性证明正是对这一变体给出的(第 16.16 节)。
ML-KEM 这一特定变体中有一个细节很容易被忽略。封装密钥的哈希 \(h = H(ek)\) 与消息一起输入 \(G\),从而把共享秘密绑定到生成它时所用的公钥上。FIPS 203 在这里也偏离了第三轮的 Kyber 提交方案:封装不再把密文哈希进共享秘密 [1]。这一改动之所以安全,恰恰是因为重加密检查已经把密文与消息绑定在一起。
16.15解密失败#
重加密并比较假设解密返回的就是被加密的那条消息。对于格方案,这只是几乎总是成立。第 15 章的噪声有很小的概率会把某个系数推过舍入边界,从而翻转 \(m'\) 的一个比特;此时重新计算的密文无法匹配,解封装返回错误的密钥。这是一个正确性失败,而不是攻击,FIPS 203 列出了其概率 [1]:
| 参数集 | 解封装失败率 |
|---|---|
| ML-KEM-512 | \(2^{-138.8}\) |
| ML-KEM-768 | \(2^{-164.8}\) |
| ML-KEM-1024 | \(2^{-174.8}\) |
这些数字并不仅仅关乎可靠性。解密失败是一种泄露:它只发生在噪声与秘密钥相关的密文上,因此能够找到失败密文的攻击者就能获知关于 \(\mathbf{s}\) 的某些信息,而且随着失败率上升,FO 的安全界会随之退化。这就是为什么失败率被压到远低于用户可能察觉的水平,也是为什么参数选择把它当作一个安全量,而不是工程容差。对 LAC 等早期基于 LWE 的设计的攻击表明,攻击者精心构造的密文和可观察到的失败事件能够把这种相关性变成一个实用的预言机 [5];畸形输入、计时和重试行为都不得泄露是哪一项内部检查失败了。
16.15.1超越 ML-KEM 的压缩#
ML-KEM 已经通过量化对多项式系数进行了压缩。更激进的研究提案则把密文视为一种结构化的通信信号,并使用格编码或打包,包括在多接收方的场景中 [6]。这并不是普通的无损压缩:译码器、噪声分布、失败概率、解封装开销以及选择密文安全性证明都会一同改变。因此,一个关于尺寸的论断若不报告实际传输的字节数、译码器的计算量与内存、在实际噪声模型下的失败概率,以及将多个接收方打包在一起所引入的任何额外假设,就是不完整的。
16.16随机预言机模型及其量子版本#
FO 证明依赖于一个明确的假设,FIPS 203 本身对此有所说明:分析“在哈希函数和 XOF 表现得像均匀随机函数这一启发式假设下”成立 [1]。这就是随机预言机模型(ROM)。在该模型中,\(G\)、\(H\) 和 \(J\) 被替换为真正的随机函数,任何一方——无论诚实还是敌对——都只能以黑盒方式查询它们。这个模型是一种启发式,而且人们清楚这一点:SHA3-512 是一个固定的公开算法,而不是随机函数。但在该模型中得到的证明在实践中一直是可靠的指引,迄今还没有任何已部署方案的破解被追溯到这一差距。
对于后量子密码,这一启发式需要重新审视,而在这里,故事变得与本书的主题密切相关。量子攻击者并不是以黑盒方式查询 SHA3 的。该函数是公开的,因此攻击者可以构建电路,并在输入的叠加态上对其求值,从而一次性提取关于许多输出的信息。要忠实地刻画这一点,就需要量子随机预言机模型(QROM),它由 Boneh 及其合作者提出 [7],在该模型中,预言机查询本身可以是叠加态。
这种区分并非吹毛求疵,因为经典 ROM 证明并不会自动在这一转变后依然成立。其中很多证明的做法是观察攻击者的查询并从中读出有用的那一个——归约只需观察攻击者对哪个 \(m\) 做了哈希。面对叠加态查询,这一步是不合法的:测量一个量子查询会扰动它。因此,在 QROM 中重新建立 FO 的安全性本身就是一个研究课题,始于 Hofheinz、Hövelmanns 和 Kiltz 的模块化分析 [4],并延续为一系列针对隐式拒绝变体的越来越紧的界 [8]。
这就是 FIPS 203 只声称 ML-KEM “被认为满足所谓的 IND-CCA2 安全性” [1] 的真实原因。格假设是一个不确定性来源;随机预言机启发式在其量子形式下,是第二个且相当独立的不确定性来源。如果读者只从本节带走一件事,那应当是:“可证明安全”总是伴随着一个模型——而对于本书中的每一个 KEM,该模型都包含一个以任何真实哈希函数都无法达到的方式被理想化了的哈希函数。
16.17参数集#
| 方案 | \(k\) | \(\eta_1\) | \((d_u,d_v)\) | NIST 级别 | 相当于 |
|---|---|---|---|---|---|
| ML-KEM-512 | 2 | 3 | \((10,4)\) | 1 | AES-128 |
| ML-KEM-768 | 3 | 2 | \((10,4)\) | 3 | AES-192 |
| ML-KEM-1024 | 4 | 2 | \((11,5)\) | 5 | AES-256 |
16.18SageMath 实验#
学习本章最有效的方式是通过三个简短的实验。
实验 1:验证 ExpandA#
使用同一个种子两次:
A1 = expand_A(1234)
A2 = expand_A(1234)
然后验证 \(A_1 = A_2\)。现在改变种子,观察矩阵也随之改变。
实验 2:考察 CBD 的统计特性#
从 CBD 分布中生成大量样本,并检查其平均值接近于零。
from random import randint

def cbd(eta):
    return sum(randint(0, 1) for _ in range(eta)) - \
           sum(randint(0, 1) for _ in range(eta))

samples = [cbd(2) for _ in range(10000)]
print(sum(samples) / len(samples))
观察当 \(\eta\) 改变时方差如何变化。
实验 3:实现密钥生成的教学版本#
最后,编写一个函数
pk, sk = keygen(seed)并测试以下性质:
相同的种子给出相同的密钥对;
不同的种子给出不同的密钥对。
这让人初步体会到,现代公钥密码是如何由确定性伪随机过程构建起来的。
实验 4:一次 MultiplyNTTs 基乘积#
FIPS 203 中的 NTT 域乘法并不是 256 个相互独立的标量乘积。每对坐标都是在模一个二次关系的意义下相乘的。下面的检查实现了其中一对;它测试的是代数上的基本情形,而不是完整的标准化变换或其序列化。
q = 3329

def multiply_ntt_pair(a, b, gamma):
    a0, a1 = a
    b0, b1 = b
    return ((a0*b0 + gamma*a1*b1) % q,
            (a0*b1 + a1*b0) % q)

# (1 + 2X)(3 + 4X) modulo X^2 - gamma, with gamma = 17.
got = multiply_ntt_pair((1, 2), (3, 4), 17)
assert got == ((3 + 17*8) % q, (4 + 6) % q)
print("one ML-KEM quadratic base product:", got)
这恰好就是 MultiplyNTTs 使用 128 次的局部乘法;一个符合标准的 ML-KEM 实现还必须使用 FIPS 203 规定的变换顺序、旋转因子、约简、编码以及测试向量。
16.19一个完整的 SageMath 实现#
上面的实验演示了各个单独的部件。配套文件 sage/fips203_mlkem.sage 把它们全部组装成 FIPS 203 的一个完整的、字节级精确的实现:标准中编号的二十一个算法,每一个都以独立函数的形式出现,以标准中的名称命名并标注其算法编号,且适用于全部三个参数集。
在浏览器中运行:本章的全部算法,覆盖全部三个参数集。参见 appliedpqc.io/playground.html,无需安装。
其中的代数对象是真正的 Sage 对象,而不是不透明的字节数组。系数域就是商环本身, \[R_q = \mathbb{Z}_q[X]/(X^{256}+1),\] 而 NTT 域 \(T_q\) 则以 \(\mathbb{F}_q\) 上的 Sage 向量来承载:
MLKEM_n, MLKEM_q, MLKEM_zeta = 256, 3329, 17

Fq = GF(MLKEM_q)
Rx = PolynomialRing(Fq, 'X')
X  = Rx.gen()
Rq = Rx.quotient(X^MLKEM_n + 1, 'x')   # coefficient domain
Tq = VectorSpace(Fq, MLKEM_n)          # NTT domain

ZETA  = [Fq(MLKEM_zeta)^BitRev7(i) for i in range(128)]
GAMMA = [Fq(MLKEM_zeta)^(2*BitRev7(i) + 1) for i in range(128)]
在此基础上,变换就是直接在 \(\mathbb{F}_q\) 上写出的标准蝶形网络:
def NTT(f):
    """Algorithm 9. Map f in Rq to its NTT representation in Tq."""
    fh = _coeffs(f)
    i, length = 1, 128
    while length >= 2:
        for start in range(0, MLKEM_n, 2*length):
            z = ZETA[i]; i += 1
            for j in range(start, start + length):
                t = z * fh[j + length]
                fh[j + length] = fh[j] - t
                fh[j]          = fh[j] + t
        length //= 2
    return vector(Fq, fh)
于是,密钥生成就是本章的七个阶段,逐行对应:
def KPKE_KeyGen(self, d):
    """Algorithm 13. K-PKE.KeyGen(d) -> (ek_PKE, dk_PKE)."""
    k = self.k
    rho, sigma = _G(bytes(d) + bytes([k]))   # domain separator k
    N = 0
    Ah = self._ExpandA(rho)
    s = []
    for _ in range(k):
        s.append(SamplePolyCBD(self.eta1, _PRF(self.eta1, sigma, N))); N += 1
    e = []
    for _ in range(k):
        e.append(SamplePolyCBD(self.eta1, _PRF(self.eta1, sigma, N))); N += 1
    sh = [NTT(si) for si in s]
    eh = [NTT(ei) for ei in e]
    th = [ntt_vec_dot(Ah[i], sh) + eh[i] for i in range(k)]
    ek = b"".join(ByteEncode(12, _ints(t)) for t in th) + rho
    dk = b"".join(ByteEncode(12, _ints(si)) for si in sh)
    return ek, dk
注意第一行中附加到种子上的字节 k:FIPS 203 对三个参数集进行了域分离,使得在错误参数集下扩展的种子会产生一个毫不相关的密钥。
为什么计算机代数系统在这里物有所值。#
由于 \(R_q\) 是一个真正的 Sage 环,手写的变换就可以对照它声称实现的代数结构来检验,而不仅仅是自我检验。定义在 sage/fips203_mlkem.sage 末尾的函数 verify_ntt_is_a_ring_isomorphism() 以 Sage 自身的算术为预言机,确认三件事:\(\mathrm{NTT}^{-1}\) 是 \(\mathrm{NTT}\) 的逆;第 \(i\) 个输出系数对确实是 \(f \bmod (X^2-\gamma_i)\),因此该变换就是到 \(X^{256}+1\) 的 \(128\) 个二次因子上的中国剩余定理映射;以及 \[\mathrm{NTT}(f\cdot g) \;=\; \text{M}{\small\text{ULTIPLY}}\text{NTT}{\small\text{S}}\big(\mathrm{NTT}(f),\,\mathrm{NTT}(g)\big),\] 其中左边的乘积由 Sage 在 \(R_q\) 中计算。最后这个恒等式恰恰就是在陈述 NTT 是一个环同构 \(R_q \to T_q\)——这是本章前面单个基乘积的检查只能略作暗示的事实。
验证。#
正确性不是靠论证得来的,而是靠测量。测试运行器 sage/test_kat.sage 用 NIST 的 ACVP 测试向量 [10] 检验该实现,这些测试向量包含每个用例的输入和预期输出:密钥生成、封装、解封装,以及第 7.2 节和第 7.3 节中的封装密钥与解封装密钥有效性检查。在 ML-KEM-512、768 和 1024 上,所有输出都逐字节匹配。在本书的 latex/ 目录下,运行 make kat 即可执行该测试。
16.20常见陷阱#
陷阱 1:认为矩阵 \(A\) 是被显式存储的#
在标准中并非如此。矩阵由 \(\rho\) 导出,因此在需要时重新生成。
陷阱 2:认为 CBD 是真正的随机采样#
CBD 并不是朴素意义上的随机采样。它是一个由种子和扩展函数驱动的确定性采样过程。
陷阱 3:认为 KeyGen 在每一步都调用随机数生成器#
在真正的算法中,初始种子 \(d\) 是引入新鲜随机性的唯一地方。此后的一切都是确定性变换。
陷阱 4:在解密失败时返回错误#
如果一个实现发出“坏密文”的信号,而不是返回隐式拒绝密钥 \(J(z\,\|\,c)\),就会重新引入解密失败预言机,从而破坏 CCA 安全性。比较 \(c'=c\) 以及在 \(K'\) 与 \(J(z\,\|\,c)\) 之间的选择都必须是常数时间的。
16.21小结#
ML-KEM 是一个两层构造,本章从头到尾把它构建了出来:
内层的 K-PKE 是一个 CPA 安全的公钥加密方案,其整个密钥生成是对单个种子的确定性扩展, \[d \longrightarrow (\rho,\sigma) \longrightarrow (A,s,e) \longrightarrow t \longrightarrow (\rho,t),\] 只公开 \((\rho,t)\),从不公开 \(A\);
封装隐藏一条随机消息 \(m\),通过对 \(m\) 进行哈希同时导出共享密钥 \(K\) 和加密随机性 \(r\),因此密文是 \(m\) 的确定性函数;
解封装先解密,再重加密,然后比较——匹配时返回真实密钥,不匹配时返回伪随机密钥 \(J(z\,\|\,c)\)。这就是带隐式拒绝的 Fujisaki–Okamoto 变换,正是它把 CPA 安全性提升为 IND-CCA2 安全性。
至此,我们完成了第一个 NIST 后量子标准 FIPS 203,从单个随机种子一直到 CCA 安全的共享密钥。下一部分将从密钥建立转向公钥密码的另一半——数字签名——首先介绍基于格的标准 ML-DSA 和 FN-DSA,它们复用了这里构建的大量机制(模格、CBD 采样、NTT)。
评论