第 8 章Gram–Schmidt 正交化与 LLL 算法
8.1本章为何重要#
本章常被称为格基约化的核心。原因很简单:一旦我们理解了格是什么,以及为什么某些基比另一些更好,就需要一种方法来度量并改进这种质量。Gram–Schmidt 正交化恰好提供了这一工具。它是 LLL、BKZ、Babai 最近平面算法 [1]以及许多其他格技术的概念基础。
8.2学习目标#
读完本章后,你应当能够:
解释为什么有些格基是好的,而另一些是坏的;
理解正交性的含义;
从概念上描述 Gram–Schmidt 正交化做了什么;
理解 LLL 为什么反复使用 Gram–Schmidt 信息;
将基的质量与 LLL、BKZ 等后续算法联系起来。
8.3什么样的基是好基?#
我们从直观认识而非公式入手。考虑平面上的两组基。一组中,向量短且近乎垂直;另一组中,向量长且近乎平行。二者可能生成同一个格,但第二组处理起来要困难得多。
好基(good basis)是让格易于“导航”的基。坏基则把短向量隐藏起来,使格看上去比实际复杂得多。
8.4为什么近乎平行的向量是坏的#
假设我们有一组坏基,由两个几乎共线的向量组成。为了表示像 \((1,0)\) 这样简单的向量,可能需要用到基向量的非常大的整数组合。这意味着坐标表示变得不稳定且数值很大。在密码学中,这正是我们要避免的。
这就是格基约化旨在寻找更好的基的原因。
8.5正交是什么意思?#
两个向量 \(u\) 与 \(v\) 称为正交的,如果
\[u \cdot v = 0.\]
例如,\((1,0)\) 与 \((0,1)\) 是正交的;相反,\((2,1)\) 与 \((3,2)\) 不是。
8.5.1Sage 实验:点积#
u = vector(QQ, [1, 0])
v = vector(QQ, [0, 1])
u.dot_product(v)
结果为 \(0\),表明这两个向量正交。
8.6Gram–Schmidt 做了什么#
Gram–Schmidt 过程不改变格。从根本意义上说,它甚至不改变基。它所做的是分析一组基,把每个向量拆分为两部分:
沿先前各方向的分量;
指向真正新方向的新分量。
通过这种方式,该过程分离出每个向量中贡献新几何信息的那一部分。所得向量彼此正交,并揭示了基中蕴含的真实方向。
这就是为什么 Gram–Schmidt 常被描述为一种剥离旧方向、只保留新方向的方法。
8.7投影公式#
若 \(u\) 与 \(v\) 是向量,则 \(v\) 在 \(u\) 上的投影为
\[\operatorname{proj}_u(v)=\frac{u\cdot v}{u\cdot u}u.\]
Gram–Schmidt 过程从 \(v\) 中减去这一投影,留下 \(v\) 中与 \(u\) 正交的部分。
8.8Gram–Schmidt 构造#
第一个向量保持不变:
\[b_1^* = b_1.\]
随后的每个向量都通过减去其在先前各方向上的投影来调整:
\[b_i^* = b_i - \sum_{j<i} \mu_{i,j} b_j^*,\]
其中系数 \(\mu_{i,j}\) 的选取使得新向量与先前各向量正交。
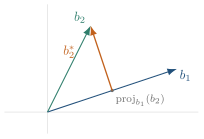
这一公式可以直接推广为一个算法:逐个处理基向量,对每个向量减去它在所有先前已正交化方向上的投影。
8.9Sage 实验:Gram–Schmidt#
B = matrix(QQ, [[2, 1], [1, 3]])
B.gram_schmidt()
输出是由原始基导出的一组正交向量。它们本身不一定是格向量,但对分析极为有用。
8.9.1验证#
u = vector(QQ, [2, 1])
v = vector(QQ, [-1, 2])
u.dot_product(v)
点积应为 \(0\),表明这两个向量正交。
8.10为什么 Gram–Schmidt 不改变格#
这是一个微妙但重要的问题。Gram–Schmidt 向量通常不是整数向量,甚至可能根本不在格中。它们是分析工具,而不是新的格生成元。它们的作用是揭示格基的几何结构,而不是取代格基。
8.11Gram–Schmidt 长度#
Gram–Schmidt 向量的长度
\[\|b_i^*\|,\]
是衡量基质量的关键指标。如果这些长度平缓递减并保持相当均衡,则该基是好的;如果某个向量变得极短而另一个变得极长,则该基质量较差。
8.12正交性缺陷#
正交性缺陷(orthogonality defect)是一个有用的质量度量。其一种形式为
\[\mathrm{OD}(B)=\frac{\prod_i \|b_i\|}{\det(B)}.\]
若基向量完全正交,则缺陷为 \(1\)。缺陷越大,基越差。
8.13Hadamard 比#
另一个标准量是 Hadamard 比:
\[\mathrm{HR}(B)=\left(\frac{\det(B)}{\prod_i \|b_i\|}\right)^{1/n}.\]
它的取值介于 \(0\) 与 \(1\) 之间,越接近 \(1\) 表示基的质量越好。
8.14LLL 为什么反复使用 Gram–Schmidt#
LLL 算法 [2]建立在这样一个思想之上:通过反复检查 Gram–Schmidt 信息,可以逐步改进一组基。如果当前基约化得不够充分,LLL 就交换向量、重新缩放,并重新计算正交化方向,直到基的质量可以接受为止。
因此,Gram–Schmidt 并非一个旁枝概念:它是最重要的格基约化算法之一背后的引擎。该算法在两种操作之间交替进行:尺寸约化(size reduction),利用系数 \(\mu_{i,j}\) 使每个 \(b_i\) 尽可能接近先前各向量张成的空间,同时不改变格;以及 Lovász 条件,这是对相邻 Gram–Schmidt 长度的一项检验,用以决定两个相邻向量是否应当交换。
每次交换都会严格减小一个由 Gram–Schmidt 长度构造的势函数,因此循环必然终止;在实践中,即使在基于格的密码体制所用的数百维情形下,它也只需少数几轮即可收敛。输出并不是可能的最短基,但它可证明地足够短——每个 \(\|b_i\|\) 都能用真正的最短向量加以界定——这使得 LLL 成为任何正式格攻击之前的主力预处理步骤。
8.15与 LWE 的联系#
本章也有助于解释为什么格问题是困难的。在 LWE 中,秘密和误差隐藏在一个高维结构之中。如果攻击者能够得到相关格的一组好基,许多相关任务都会变得容易得多。基于格的密码的安全性正是建立在这样的假设之上:这样的基不易获得。
8.16实验#
8.16.1实验 1:正交性#
u = vector(QQ, [1, 0])
v = vector(QQ, [0, 1])
u.dot_product(v)8.16.2实验 2:比较两对向量#
u = vector(QQ, [100, 99])
v = vector(QQ, [101, 100])
u.dot_product(v)
将结果与前一个实验进行比较。
8.16.3实验 3:在 Sage 中做 Gram–Schmidt#
B = random_matrix(QQ, 3)
B.gram_schmidt()8.16.4实验 4:正交性缺陷#
生成若干组随机基,并比较它们的正交性缺陷值。
8.17小结#
本章介绍了基质量的几何概念。Gram–Schmidt 正交化并不是一种新的格构造;它是一种分析基的方法,把旧方向与真正的新方向区分开来。好基短且近乎正交,而坏基长且近乎平行。这些思想是 LLL 及其他约化算法的直接前导。
下一章最短向量问题(SVP)将把这些几何思想与一个具体的困难问题联系起来。此后,本书将转向噪声分布和带误差学习问题,解释为什么格问题与现代后量子密码的安全性如此紧密相关。
评论