第 9 章最短向量问题(SVP)
9.1什么是最短向量?#
回忆一下,给定一组基 \[B=(b_1,b_2,\dots,b_n),\] 格由其所有整系数线性组合构成: \[L(B)=\left\{\sum_{i=1}^n z_i b_i : z_i\in\mathbb{Z}\right\}.\]
最短向量问题(shortest vector problem, SVP)要求在所有非零格点中找出欧几里得范数最小的那一个。形式化地, \[\lambda_1(L)=\min_{v\in L\setminus\{0\}} \|v\|.\] 量 \(\lambda_1(L)\) 称为第一逐次极小(first successive minimum)。在文献中,这个量在格密码学里反复出现。
换言之,如果我们设想基向量的所有整数组合,那么最短向量就是离原点最近的非零格点。
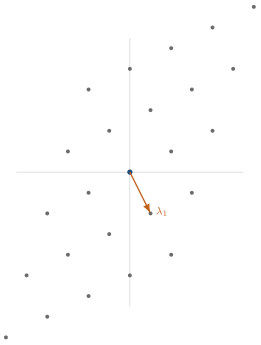
9.2为什么二维 SVP 很容易?#
在低维情形下,几何结构仍然是可见的。在二维中,人们往往可以看着格的图形用肉眼找出最短向量。在三维中仍可进行几何推理,但图形已不那么直观。到了四维及以上,人的直觉变得很弱。等到 256 维时,已经没有任何有意义的方式能直接将其几何结构可视化。
这就是格问题在高维中变得计算困难的原因。搜索空间呈指数增长,蛮力方法毫无希望。
9.3为什么蛮力搜索不可行#
假设我们尝试在维数 \(100\) 的格中进行搜索。若每个系数取自 \(-5,\dots,5\),则每个坐标有 \(11\) 种可能。候选向量的总数为 \[11^{100},\] 约为 \[1.37\times 10^{104}.\] 这远远超过可观测宇宙中的原子数。因此穷举搜索是不可行的。
确切地说,蛮力搜索就是第 7 章中的算法 5,外加一个记录迄今所见最小范数的步骤:
循环体的开销很小,但循环本身要访问 \((2N+1)^n\) 个候选。当 \(n=100\)、\(N=5\) 时,这正是上面的 \(11^{100}\);使精确 SVP 变得困难的,是这种随 \(n\) 的指数爆炸,而不是内层计算的任何低效。
9.4初学者的常见陷阱#
许多初学者以为最短向量必定是某个基向量本身。这并不正确。最短向量是一个格向量,但它不必等于任何单个基向量。例如,最短向量可以是基向量的组合,如 \[b_2-b_1,\] 它可能比任一基向量单独都更短。
这意味着求解 SVP 需要考察整个格结构,而不仅仅是恰好给定的那组基。
9.5Sage 实验#
我们可以构造一个小格,并让 Sage 求出它的最短向量。
from sage.modules.free_module_integer import IntegerLattice

B = matrix(ZZ, [[2, 1], [1, 3]])
L = IntegerLattice(B)
print(L.shortest_vector())
print(L.shortest_vector().norm())
输出给出一个最短格向量及其欧几里得范数。这就是最基本的 SVP 实例。
9.6Minkowski 定理#
Minkowski 定理是格理论的基础性结果之一。它指出,\(n\) 维格必定包含一个非零向量,其范数至多为 \[\sqrt{n}\,\det(L)^{1/n}.\]
其中的重要直觉很简单:如果格是稠密的,那么最短向量不可能太长;如果格是稀疏的,那么最近的格点就离得更远。Minkowski 定理保证了存在一个不太长的向量,尽管它并没有告诉我们如何高效地找到它。
9.7精确 SVP 与近似 SVP#
精确 SVP 与近似 SVP 之间有一个重要区别。
精确 SVP 要求找到真正的最短向量。
近似 SVP 只要求找到一个长度在最优值的 \(\gamma\) 倍以内的向量。
按照文献中的记法,\(\gamma\)-SVP 求解器返回的向量长度至多为 \[\gamma\,\lambda_1(L).\]
这一区别很重要,因为格密码分析中的实用算法通常并不求解精确 SVP,而是求解近似变体,后者要容易处理得多。
9.8为什么 LLL 不能求解精确 SVP#
LLL 算法极其有用,但它的目标并不是找出精确的最短向量。它所做的是把一组基变换为约化程度更高的基,往往能产生一个比原始向量短得多的向量。然而,LLL 返回的向量通常并不保证是真正的最短向量。在许多情况下,它只是一个良好的近似。
9.9为什么 BKZ 更强#
BKZ 通过处理格的局部分块来改进 LLL。它在一个滑动窗口内反复求解小维数的 SVP 实例,然后利用所得的短向量来改进全局基。这使 BKZ 比 LLL 更强,但也大幅增加了计算开销。在实践中,BKZ 能找到非常短的向量,但在高维中仍然不能保证求解精确 SVP。
9.10为什么 SVP 是困难的#
就目前而言,已知求解精确 SVP 的最佳经典算法在维数上仍是指数级的,而且没有任何已知的量子算法能提供 Shor 算法对因数分解所带来的那种巨大加速。因此,基于格的密码仍是实现后量子安全的一条实用且有理论依据的途径。
9.11与 LWE 的联系#
与带误差学习(LWE)的联系是核心所在。LWE 问题可以看作格上的一个带噪声的线性方程组。如果能够高效求解相关的格问题(包括在适当设定下的 SVP),那么许多针对 LWE 的攻击将变得强大得多。Regev 归约的方向则相反:最坏情形的格问题可归约到平均情形的 LWE,因此一个能在随机实例上攻破 LWE 的高效算法将能在每一个格上求解近似格问题。第 11 章将精确陈述这一定理,并讨论它在实际部署参数下能保证什么、不能保证什么。
9.12要点#
SVP 要求的是最短的非零格向量,而不仅仅是最短的基向量。
SVP 的困难性随维数迅速增长。
LLL 与 BKZ 求解的是 SVP 的近似版本,一般而言并不求解精确问题。
SVP 与 LWE 之间的联系是人们相信基于格的密码安全的核心原因之一。
评论