第 13 章模 LWE(MLWE)
13.1基于格的密码的三代#
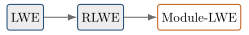
我们已经看到了基于格的密码发展中的三个主要阶段。
第一代:LWE。其方程为 \[b = A s + e,\] 其中 \(A\) 是一个随机矩阵。其安全性证明很优雅,但表示规模大,计算代价高。
第二代:RLWE。矩阵被多项式环结构所取代。计算变得快得多,但代数结构变得更强、更特殊。
第三代:模 LWE。这是规模大但简单的 LWE 构造与紧凑但高度结构化的 RLWE 构造之间的折中。
因此,历史路径为:
13.2什么是模?#
“模”(module)一词并不是随意的行话;它是一个精确的代数结构,而 Kyber 的秘密就位于其中。它推广了第 3 章的向量空间,允许标量来自环而不是域。
定义 13.1 (环上的模). 设 \(R\) 是一个具有单位元 \(1\) 的交换环。一个(左)\(R\)-模是一个阿贝尔群 \((M,+)\),连同一个标量乘法 \(R\times M\to M\)(记作 \((r,m)\mapsto rm\)),使得对所有 \(r,s\in R\) 和 \(x,y\in M\) 有:
\(r(x+y)=rx+ry\);
\((r+s)x=rx+sx\);
\((rs)x=r(sx)\);
\(1\,x=x\)。
这些恰好就是把域换成环之后的向量空间公理。当 \(R\) 是域时,\(R\)-模就是向量空间;模是把“域”放宽为“环”所得到的严格更一般的对象。若干性质得以保留,而有一项便利之处丧失了。
自由模与秩。集合 \(R^{k}=\{(m_1,\dots,m_k):m_i\in R\}\) 在逐分量运算下是一个 \(R\)-模,称为秩为 \(k\) 的自由模。与向量空间一样,它有一组基——标准单位向量 \(e_1,\dots,e_k\)——因此每个元素都能唯一地表示为它们的 \(R\)-组合。Kyber 的秘密空间恰好就是自由模 \(R_q^{k}\)。
矩阵作为同态作用。矩阵 \(A\in R^{k\times k}\) 定义了一个 \(R\)-线性映射 \(R^{k}\to R^{k}\),\(\mathbf{x}\mapsto A\mathbf{x}\),称为\(R\)-模同态。模 LWE 映射 \(\mathbf{s}\mapsto A\mathbf{s}\) 就是其中之一。
子模与理想。子模是子空间的类比;把 \(R\) 看作自身上的模时,其子模恰好就是它的理想(第 4 章)——这就是为什么说 RLWE 建立在理想格之上。
丧失了什么。在一般的环上,并非每个模都是自由的,也并非每个子模都有基——这是与向量空间的一个实质性区别。Kyber 通过在自由模 \(R_q^{k}\) 中工作而完全避开了这一点。
精确地命名了这一结构之后,三代演进就成了关于秘密位于哪个模中的陈述: \[\underbrace{s\in\mathbb{Z}_q^{n}}_{\text{LWE}} \qquad \underbrace{s(x)\in R_q}_{\text{RLWE}} \qquad \underbrace{\mathbf{s}\in R_q^{k}}_{\text{Module-LWE}}.\] LWE 使用域元素组成的向量;RLWE 使用单个环元素;模 LWE 使用环 \(R_q\) 上长度为 \(k\) 的向量——一个秩为 \(k\) 的自由模。
13.3Kyber 的秘密#
在 ML-KEM(Kyber)中,秘密不是单个多项式,而是一个多项式向量。安全级别决定了该向量的维数。
Kyber512 使用 \(k=2\)。
Kyber768 使用 \(k=3\)。
Kyber1024 使用 \(k=4\)。
因此,安全级别与模的大小相关联。
13.4为什么矩阵又回来了?#
乍看之下,人们会惊讶于在 Kyber 中再次看到矩阵。但这个矩阵并不是整数上的大型随机矩阵,其元素是多项式。
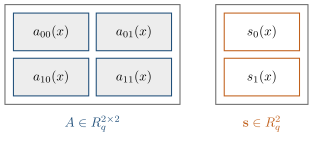
例如,对于 \(k=2\),我们可以有 \[A = \begin{bmatrix} a_{11}(x) & a_{12}(x) \\ a_{21}(x) & a_{22}(x) \end{bmatrix}.\]
每个元素都是环 \(R_q\) 中的一个多项式。这个对象仍然是矩阵,但矩阵元素现在是环元素,而不是普通的数。
13.5Kyber 公钥生成#
公钥生成在思想上与 LWE 非常相似。我们选取一个秘密向量 \(\mathbf{s}\)、一个噪声向量 \(\mathbf{e}\) 以及一个多项式矩阵 \(A\),然后计算 \[\mathbf{t} = A\mathbf{s} + \mathbf{e}.\]
这与 LWE 的支配思想完全相同,只是标量现在变成了环元素。下图针对最小情形 \(k=2\) 具体展示了 \(A\) 与 \(\mathbf{s}\) 的形状(下标从 \(0\) 到 \(k-1\),与下面的 Sage 代码一致)。
13.6为什么这比普通 LWE 更好?#
我们可以比较这三种设计。
LWE:矩阵巨大,公钥很大。
RLWE:表示紧凑,但代数结构非常强。
模 LWE:矩阵小,元素是多项式,在紧凑性与灵活性之间取得了非常好的折中。
换言之,模 LWE 使用一个小的多项式矩阵,而不是一个巨大的整数矩阵或单个大多项式。
13.7用 Sage 构造一个玩具版模#
我们可以在 Sage 中构造一个非常小的玩具版示例。首先定义环。
q = 17
R.<x> = PolynomialRing(GF(q))
S = R.quotient(x^8 + 1)
现在把秘密定义为由两个多项式组成的向量。
from random import choice
def small_poly():
    return S([choice([-1, 0, 1]) for _ in range(8)])

s = vector(S, [small_poly(), small_poly()])
print(s)
构造一个小的多项式矩阵。
A = Matrix(S, [[S.random_element(), S.random_element()],
               [S.random_element(), S.random_element()]])
print(A)
构造一个噪声向量。
e = vector(S, [small_poly(), small_poly()])
assert all(c in [0, 1, 16] for p in list(s) + list(e) for c in p.lift().list())
然后计算类似公钥的值。
t = A * s + e
print(t)
这具有模 LWE 样本的代数形状。公开矩阵是均匀分布的,而秘密和误差使用小系数;它仍然只是一个玩具版示例,而不是 FIPS 203 的采样器。
13.8模 LWE 问题#
有了模结构,模 LWE 就是把第 11 章的 LWE 分布中的标量从 \(\mathbb{Z}_q\) 提升到环 \(R_q\) 而得到的分布。
定义 13.2 (模 LWE). 固定环 \(R_q=\mathbb{Z}_q[x]/(x^n+1)\)、模秩 \(k\),以及 \(R_q\) 上集中于小元素的误差分布 \(\chi\)。对于秘密 \(\mathbf{s}\in R_q^{k}\),模 LWE 分布输出 \[(\mathbf{a},\,b),\qquad \mathbf{a}\leftarrow R_q^{k}\ \text{uniform},\quad e\leftarrow\chi,\quad b=\langle \mathbf{a},\mathbf{s}\rangle + e\in R_q.\] 把 \(m\) 个样本作为 \(A\in R_q^{m\times k}\) 的行堆叠起来,便得到矩阵形式 \((A,\ \mathbf{t}=A\mathbf{s}+\mathbf{e})\)。搜索 MLWE 是要恢复 \(\mathbf{s}\);判定 MLWE 是要区分 \((A,\,A\mathbf{s}+\mathbf{e})\) 与均匀的二元组 \((A,\,\mathbf{u})\)。
有两个特殊情形界定了这一定义的两端:\(k=1\) 即为 RLWE(单个环元素),而 \(n=1\) 且 \(R_q=\mathbb{Z}_q\) 则还原为普通 LWE。模 LWE 在二者之间插值,并继承了与 LWE 同类的最坏情形困难性保证:在平均情形下求解它至少与模格上的标准问题一样困难 [1]。在 Kyber 中矩阵是方阵(\(m=k\)),从而得到紧凑形式 \[\mathbf{t} = A\mathbf{s} + \mathbf{e}, \qquad A\in R_q^{k\times k},\ \ \mathbf{s},\mathbf{e}\in R_q^{k}.\]
13.9为什么模 LWE 被视为一种折中#
许多人误以为模 LWE 之所以“更好”,只是因为它使用了更多的结构。这不是正确的理解。真正的要点在于,模 LWE 削弱了纯 RLWE 最强的代数结构,同时保留了其效率优势。换言之,它在以下几者之间进行权衡:
普通 LWE 的巨大规模,
RLWE 的强结构,
以及 MLWE 所提供的实用中间地带。
这种平衡是 Kyber 设计的核心。
13.10为什么 Kyber 的参数是 \(k=2,3,4\)#
取值 \(k=2,3,4\) 对应模的不同维数,恰好就是 Kyber 的三个安全级别 [1, 2]。在实践中:
\(k=2\) 给出 Kyber512,
\(k=3\) 给出 Kyber768,
\(k=4\) 给出 Kyber1024。
增大 \(k\) 会增大模的规模,从而提高安全级别。环的维数和模数保持不变,但标准化的 ML-KEM 参数集也使用了不同的参数元组:特别地,对于 ML-KEM-512、-768 和 -1024,\(\eta_1\) 分别为 \(3,2,2\),\((d_u,d_v)\) 分别为 \((10,4),(10,4),(11,5)\) [3]。
13.11一个完整的玩具版 MLWE 实验#
一个有益的练习是完整地实现一个玩具版 MLWE。
定义环 \(R_q\)。
构造一个小的多项式矩阵 \(A\)。
构造一个多项式向量 \(\mathbf{s}\)。
构造一个噪声向量 \(\mathbf{e}\)。
计算 \(\mathbf{t}=A\mathbf{s}+\mathbf{e}\)。
打印结果并考察其结构。
这能让人切实理解为什么 Kyber 可以看作 LWE 的一种结构化推广。用伪代码写出,并沿用上面 Sage 代码中的名称 \(A\)、\(\mathbf{s}\)、\(\mathbf{e}\)、\(\mathbf{t}\),同样的六个步骤即为算法 11。
实际的 ML-KEM 具有这种算法形状,其中 \(n=256\)、\(k=2,3,4\),但各标准化参数集之间的差异不止在于 \(k\);它们的采样参数和压缩参数在 FIPS 203 中规定。
13.12小结#
关键的教训是:模 LWE 并不只是“带有更多多项式的 LWE”。它是两个极端之间的中间地带:
| 方案 | 秘密对象 | 主要思想 |
|---|---|---|
| LWE | \(\mathbb{Z}_q\) 上的向量 | 简单通用,但规模大 |
| RLWE | \(R_q\) 上的单个多项式 | 紧凑快速,但高度结构化 |
| 模 LWE | \(R_q\) 上的多项式向量 | 均衡的折中,为 Kyber 所采用 |
重要的洞见在于,Kyber 并不只是换了个名字的 RLWE。它是同一带噪声线性结构的模版本,其组织方式在保持强安全假设的同时带来了实用的效率。
评论