第 7 章格
7.1本章的意义#
本章是整门课程中最重要的章节之一。如果说前面几章介绍了向量、矩阵和多项式环,那么本章要解释的是使后量子密码成为可能的那个几何对象:格(lattice)。格是 LWE、RLWE、Kyber、Dilithium 以及许多其他现代构造背后的核心结构。
7.2学习目标#
读完本章后,你应当能够:
解释什么是格;
区分格与向量空间;
理解为什么一个格可以有许多不同的基;
理解好基与坏基之间的区别;
体会为什么 SVP 和 CVP 这类问题是困难的;
看出格问题与 LWE 之间的联系。
7.3从二维开始#
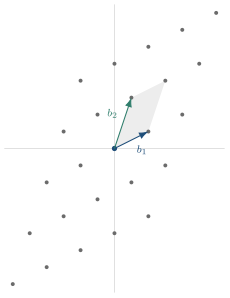
我们不直接跳入高维理论,而是从一个简单的二维例子开始。设
\[b_1 = \begin{pmatrix}2\\1\end{pmatrix}, \qquad b_2 = \begin{pmatrix}1\\3\end{pmatrix}.\]
现在只允许整数系数:
\[v = x b_1 + y b_2, \qquad x,y \in \mathbb{Z}.\]
如果取许多这样的组合,所得的点会在平面上构成一个由离散点组成的无限规则图案。这个集合称为格。
7.3.1Sage 实验:生成一个二维格#
b1 = vector(ZZ, [2, 1])
b2 = vector(ZZ, [1, 3])
points = []
for i in range(-5, 6):
    for j in range(-5, 6):
        points.append(i * b1 + j * b2)
points[:10]
输出是一个格点列表。重要的观察是:这些格点以非常规则、离散的方式排列。
7.4形式化定义#
形式地说,若 \(b_1, \ldots, b_n\) 是线性无关的向量,则集合
\[L(B) = \left\{ \sum_{i=1}^{n} z_i b_i \;:\; z_i \in \mathbb{Z} \right\}\]
称为由基 \(B = \{b_1, \ldots, b_n\}\) 生成的格。
与向量空间的关键区别在于:系数被限制为整数,而不是任意实数。
这个定义可以直接执行:在有界区域内枚举一个格,恰好就是对整数系数向量做有界搜索。
这正是上面的 Sage 实验在 \(n=2\)、\(N=5\) 时所做的:对整数系数做两重嵌套循环,收集所得的每一个点。图 7.1 中的规则网格就是这个算法的输出。
7.5为什么格不是向量空间#
向量空间允许任意的实系数或复系数。例如,
\[0.13 b_1 + 2.78 b_2\]
是由 \(b_1\) 与 \(b_2\) 张成的向量空间中一个完全合法的元素。但在格中,系数必须是整数。这就是为什么格是离散结构而非连续结构。
这一区别至关重要。密码学需要离散的问题,因为连续的问题往往很容易求解。
7.6向量空间与格的对比#
向量空间是连续而稠密的。格是离散而稀疏的。换言之:
向量空间:所有实系数的线性组合;
格:仅整数线性组合。
正是这一差别使格问题既困难又可用于密码学。
7.7一个格可以有许多基#
最重要的概念要点是:一个格可以用许多不同的基来描述。例如,基
\[\left\{(1,0), (0,1)\right\}\]
与基
\[\left\{(2,1), (1,1)\right\}\]
可以生成同一个格。
这就好比一座城市可以用不同的坐标系来描述。城市本身没有变,变的只是坐标描述。
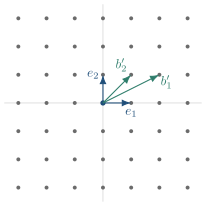
\(e_1=(1,0),\ e_2=(0,1) \qquad b_1'=(2,1),\ b_2'=(1,1)\)
7.7.1Sage 实验:两组不同的基#
B1 = matrix(ZZ, [[1, 0], [0, 1]])
B2 = matrix(ZZ, [[2, 1], [1, 1]])
稍后我们将验证它们生成的是同一个格。
7.8好基与坏基#
现在我们来到格基约化背后的核心思想。有些基是好的,有些基是坏的。
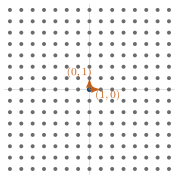
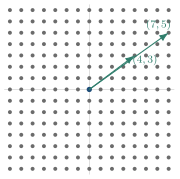
坏基由近乎平行且很长的向量组成。这样的基使人很难找到邻近的格点。
好基由相对较短且近乎正交的向量组成,使人更容易在格中“导航”。
这就是 LLL 和 BKZ 等算法存在的原因:它们试图把一组坏基变换为一组更好的基。
7.9基本平行多面体#
给定一组基,就可以构成基本平行多面体,即格的基本单元。它的体积与基矩阵的行列式有关。
对于二维格,这个单元的面积由行列式的绝对值给出。
7.9.1Sage 实验:行列式#
B = matrix(ZZ, [[2, 1], [1, 3]])
B.det()
行列式衡量的是格的稠密程度。行列式越大,通常意味着格越稀疏;行列式越小,则意味着格越稠密。
7.10格的维数#
在二维中,格很容易可视化。然而在密码学中,维数要大得多。Kyber、Dilithium 及其他基于格的系统可能在数百乃至数千维中工作。在这样的高维空间中,几何图景要难以想象得多,但许多相同的直觉依然适用。
7.11为什么格问题会变得困难#
在低维中,人们常常可以手工或借助简单的几何论证来求解格问题。然而在更高维中,寻找短向量或邻近向量会变得极其困难。这种复杂度的爆炸式增长正是基于格的安全性的基础。
7.12Sage 实验:最短向量#
Sage 提供了内置的格工具。可以按如下方式直接由整数矩阵创建一个格对象:
from sage.modules.free_module_integer import IntegerLattice

B = matrix(ZZ, [[2, 1], [1, 3]])
L = IntegerLattice(B)
L
定义好格之后,只需一条命令即可计算最短向量:
L.shortest_vector()这就是最短向量问题(SVP)背后的基本对象,而 SVP 是基于格的密码学中核心的困难性假设之一。
7.13实验#
ML-KEM(FIPS 203 [1])与 ML-DSA(FIPS 204 [2])底层的格位于数百维的空间中,其几何结构无法可视化。下面的实验在二维中——在那里每个对象都可以画出来并手工核验——分离出这些标准最终所依赖的四个现象:点集的离散性、行列式的基不变性、好基与坏基之间的差距,以及最短向量的难解性。每一个现象在原理上都原封不动地出现在密码学规模中。
7.13.1实验 1:枚举格#
生成格 \(\Lambda(\mathbf{b}_1,\mathbf{b}_2)\) 的一个有限窗口,并确认它是一个离散的点阵网格,而不是连续的张成空间。
b1 = vector(ZZ, [2, 1])
b2 = vector(ZZ, [1, 3])
pts = [i * b1 + j * b2 for i in range(-4, 5) for j in range(-4, 5)]
pts
绘制 pts 即可看到典型的规则网格。正是这同一个对象,在维数为 \(256\) 且定义在 \(\mathbb{Z}_q\) 而非 \(\mathbb{Z}\) 上时,成为 ML-KEM 核心的模格。
7.13.2实验 2:行列式是基不变量#
对同一个格的若干组基计算格行列式 \(\det\Lambda = |\det B|\),每组基都由 \(B\) 左乘一个幺模矩阵 \(U \in \mathrm{GL}_n(\mathbb{Z})\)(即满足 \(\det U = \pm 1\) 的整数矩阵)得到。
B = matrix(ZZ, [[2, 1], [1, 3]])
U = matrix(ZZ, [[1, 0], [1, 1]])          # unimodular: det U = 1
print(abs(B.det()), abs((U * B).det()))   # identical
行列式——即基本平行多面体的余体积,因而也是格密度的倒数——保持不变,而基向量本身则完全改变。这种在 \(\mathrm{GL}_n(\mathbb{Z})\) 作用下的不变性,恰恰使一个方案能够公开格的一组基,而秘密持有另一组基。
7.13.3实验 3:好基与坏基#
同一个格既有近乎正交的(“好”)基,也有高度倾斜的(“坏”)基。对比两者,并通过正交性缺陷 \(\prod_i \lVert \mathbf{b}_i\rVert / \det\Lambda\) 来量化倾斜程度。
good = matrix(ZZ, [[1, 0], [0, 1]])       # orthonormal basis of Z^2
bad  = matrix(ZZ, [[1, 7], [0, 1]])       # a sheared basis of the same Z^2
这一差距是陷门格密码的核心。在基于 NTRU 的 FN-DSA 中,以及在精神上贯穿整个 ML-DSA(FIPS 204 [2])的设计中,秘密钥充当好基,公钥充当坏基;在没有好基的情况下伪造签名,可归约为一个困难的格问题。第 8 章将把好基与坏基的区别定量化,并说明一组坏基能被约化到多么接近好基的程度。
7.13.4实验 4:最短向量是格不变量#
对同一个格的若干组不同的基计算最短非零向量,并确认其长度是格的性质,而不是所选基的性质。
from sage.modules.free_module_integer import IntegerLattice
B1 = matrix(ZZ, [[2, 1], [1, 3]])
B2 = matrix(ZZ, [[3, 4], [4, 7]])          # = U*B1, U unimodular: same lattice
for B in [B1, B2]:
print(IntegerLattice(B).shortest_vector()) # identical length在二维中,shortest_vector 瞬间就能给出答案。而在 FIPS 203 与 204 所涉及的维数下,没有任何已知算法能在可行时间内做到这一点;这种渐近意义上的难解性——形式化为最短向量问题(SVP)及其近似版本和判定版本——正是这两项标准共同依托的安全基础。
7.14小结#
本章的主要结论有三点:
格不是向量空间;它是由整数线性组合构成的离散结构。
一个格可以有许多不同的基,而基的选择会极大地影响处理这个格的难易程度。
格问题(尤其是 SVP 和 CVP)的困难性是许多后量子密码系统的基础。
下一章Gram–Schmidt 正交化与 LLL 算法将介绍第一个把坏基变为好基的主要算法工具。
评论