第 23 章HQC
23.1学习目标#
读完本章后,你应当能够:
解释 HQC 与 Classic McEliece(第 22 章)有何不同:McEliece 隐藏码,HQC 隐藏噪声;
陈述 HQC 所依赖的困难问题——对随机准循环码译码——以及为何码本身是公开的;
把环 \(\mathbb{F}_2[x]/(x^n-1)\) 理解为准循环块,并把其中的乘法理解为 \(\mathbb{F}_2\) 上的循环卷积;
理解 KeyGen / Encapsulate / Decapsulate 流程,并亲手验证代数抵消 \(v - u\,y \approx mG\);
解释为何一个公开已知、可高效译码的码 \(C\) 能够去除残余的低重量错误并恢复消息;
在 NIST 选定进行标准化的方案中为 HQC 定位:它是 ML-KEM 的基于编码的补充。
23.2本章为何重要#
上一章构建了 Classic McEliece,这是最古老的基于编码的方案,其安全性自 1978 年以来一直经受住了考验。它的缺点众所周知:公钥极其庞大,从数百 KB 到 1 MB 不等。HQC(Hamming Quasi-Cyclic,Hamming 准循环)是一个年轻得多的基于编码的 KEM,它追求同一个目标——基于编码理论的后量子密钥封装——但从相反的方向入手,并且密钥要小得多。
这一点之所以重要,除了效率之外,还在于多样性。NIST 首批发布的后量子标准几乎全部依赖于格问题:ML-KEM 和 ML-DSA 都是格方案。倘若某个出人意料的单一进展削弱了格假设,一个建立在真正不同的困难问题之上的备份方案将很有价值。2025 年 3 月,NIST 选定 HQC [1] 作为额外的密钥封装机制进行标准化,用一个安全性依赖于随机码译码困难性而非格的方案来补充 ML-KEM。在本标准快照时点,最终的 HQC FIPS 尚未发布;本章描述的是当前的提交方案/规范,而不是最终的合规接口。
23.3核心思想:隐藏噪声,而不是隐藏码#
Classic McEliece 和 HQC 都是基于编码的,二者最终都依赖于这样一个事实:对一个看似随机的线性码译码是困难的。但它们以相反的方式利用这一事实。
Classic McEliece 隐藏码。秘密是一个结构化的码(二元 Goppa 码),其持有者知道如何高效地对它译码。公钥是一个被打乱的生成矩阵,看起来像一个没有可用结构的随机码。安全性依赖于攻击者无法把这个被伪装的结构化码与随机码区分开来,并且无法对其译码。由于公开对象本质上是一个完整的、看似随机的生成矩阵,它的尺寸很大。
HQC 隐藏噪声。可译码的码 \(C\) 是公开且固定的。所有人——包括攻击者——都知道 \(C\),也知道如何对它译码。秘密的是一对低重量向量。安全性依赖于攻击者无法从公开数据中恢复这些低重量秘密,而这恰恰就是对一个随机准循环码译码的问题。没有任何结构被隐藏,因此也就不需要公布一个庞大的伪装矩阵。
这与本书前面从 LWE 走向环 LWE 的那一步如出一辙,只是被移植到了编码理论之中。朴素的基于编码的密码与朴素的 LWE 一样,需要一个庞大的无结构矩阵。加入准循环结构后,单独一行(单个环元素)就能代表整个循环块,从而把密钥缩小很大的倍数——这正如一个循环矩阵由其第一行所决定一样。HQC 之于 McEliece,大致如同环 LWE 之于 LWE:它通过增加代数结构换来小密钥,代价是依赖于一个更具结构性的假设。第 12.15 节的 NTRU 构造在格的世界中做了同样的取舍;HQC 则是它在编码理论中的近亲。
23.4环:作为环元素的准循环块#
固定一个长度 \(n\)(在实际方案中为素数)。HQC 中的对象都位于如下的环中: \[R = \mathbb{F}_2[x]\big/(x^n-1).\] \(R\) 的一个元素是次数小于 \(n\) 的二元多项式,等价地,是一个长度为 \(n\) 的二元向量。有两个事实使这个环成为 HQC 的合适归宿。
乘法是循环卷积。#
由于 \(x^n \equiv 1\),乘以 \(x\) 就是对系数向量进行循环移位。因此,两个环元素 \(h\) 与 \(y\) 相乘,就是在 \(\mathbb{F}_2\) 上对它们的系数向量作循环卷积: \[(h\cdot y)_k \;=\; \bigoplus_{i+j\equiv k \ (\mathrm{mod}\ n)} h_i\, y_j .\] 这用到了第 5 章所介绍的卷积图景中循环/循环矩阵的那一面:映射 \(y \mapsto h\cdot y\) 就是乘以以 \(h\) 为第一行的循环矩阵。存储单个向量 \(h\) 就足以描述整个 \(n\times n\) 循环矩阵——这就是“准循环”压缩,也正是 HQC 密钥小的原因。
保持秘密的是重量。#
一个环元素的 Hamming 重量是其非零系数的个数。一个低重量元素在其 \(n\) 个坐标中只有寥寥几个 1。HQC 的秘密是低重量元素;而一个均匀随机的 \(h\) 则不是。整个安全性论证就取决于“低重量”与“随机”之间的差距。(作为量级参考,HQC-128 使用 \(n = 17669\),秘密重量 \(w = 66\):六十六个 1 隐藏在一万七千多个坐标之中。)
23.5方案#
HQC 与玩具版 ML-KEM 流程(图 14.2)具有相同的代数轮廓:一个由秘密构建的公开“校验子”,一个针对新鲜随机性重用公钥的密文,以及一个抵消共享项并对小的残余错误进行译码的解密过程。改变的只是算术——模 \(q\) 的整数变成了比特,而“小”指的是低 Hamming 重量,而不是小幅值。
23.5.1密钥生成#
采样一个均匀随机的 \(h \in R\) 以及两个低重量秘密 \(x, y \in R\)(重量均为 \(w\))。公布 \[s \;=\; x + h\cdot y .\] 公钥为 \((h, s)\),秘密钥为 \((x, y)\)。
\((h, s)\) 这一对恰好是一个准循环校验子:\(s\) 是一个看似随机的环元素,而从 \((h, s)\) 中恢复低重量的 \((x, y)\) 就是准循环校验子译码问题,人们相信即使对量子计算机而言它也是困难的。注意,\(h\) 和 \(s\) 合起来只是两个长度为 \(n\) 的向量——没有需要存储的大矩阵。
23.5.2封装#
封装在公开码 \(C\) 下加密一条消息 \(m\),然后通过对 \(m\) 求哈希来派生共享密钥。设 \(G\) 为 \(C\) 的公开生成矩阵,于是 \(mG \in R\) 就是承载 \(k\) 比特消息 \(m\) 的码字。采样新鲜的低重量随机量 \(r_1, r_2, e\) 并计算 \[u \;=\; r_1 + h\cdot r_2, \qquad v \;=\; mG + s\cdot r_2 + e .\] 密文为 \((u, v)\),共享密钥为 \(K = H(m)\),其中 \(H\) 是一个哈希函数。
这两部分与 KeyGen 相呼应:\(u\) 针对新鲜秘密 \(r_2\) 重用公开的 \(h\)(正如 \(s\) 针对 \(y\) 使用 \(h\) 一样),而 \(v\) 把码字 \(mG\) 隐藏在公开的 \(s\) 乘以 \(r_2\) 再加上少许额外噪声 \(e\) 之下。\(r_1, r_2, e\) 中的每一个都是低重量的——正是这一点使解封装后的残余很小。
23.5.3解封装#
持有 \((x, y)\) 的一方计算 \(v - u\cdot y\),并用公开码 \(C\) 对结果译码。这段代数的要点在于,\(s\) 与 \(u\) 之间的共享项相互抵消,只留下一个码字加上一个低重量错误: \[\begin{aligned} v - u\cdot y &= \big(mG + s\,r_2 + e\big) - \big(r_1 + h\,r_2\big)\,y \\[2pt] &= mG + (x + h\,y)\,r_2 + e - r_1\,y - h\,r_2\,y \\[2pt] &= mG + x\,r_2 + \underbrace{h\,y\,r_2 - h\,r_2\,y}_{=\,0} + e - r_1\,y \\[2pt] &= mG + \big(x\,r_2 - y\,r_1 + e\big). \end{aligned}\] 两份 \(h\,y\,r_2\) 之所以相互抵消,是因为 \(R\) 是交换环。(在 \(\mathbb{F}_2\) 上减法与加法相同,因此残余实际上是 \(x r_2 + y r_1 + e\);我们保留负号只是为了映照抵消的过程。)残余项 \[e' \;=\; x\,r_2 - y\,r_1 + e\] 是若干低重量向量乘积之和:\(x\,r_2\) 的重量至多为 \(w\cdot w_r\),\(y\,r_1\) 亦然,因此 \(e'\) 的重量很小且有界。它恰恰是加在真正码字 \(mG\) 上的一个低重量错误。由于 \(C\) 是一个已知的、可高效译码的码,其选取使得译码器能纠正至多这么多个错误,因此对 \(v - u\,y\) 运行公开译码器便可去除 \(e'\) 并返回 \(m\)。
只要 \(e'\) 的重量保持在 \(C\) 的译码半径之内,解封装就会成功。与 ML-KEM 一样,参数 \(n\)、\(w\)、\(w_r\)、\(w_e\) 以及码 \(C\) 都经过调校,使得失败的概率可以忽略。
23.5.4流程一览#
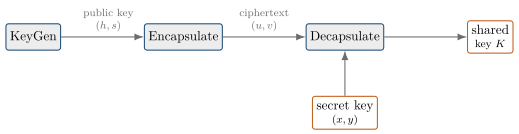
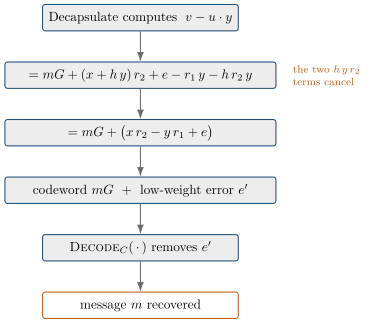
23.6公开码 \(C\)#
一切都取决于 \(C\) 是一个固定的公开码,并且在 \(e'\) 的重量范围内可高效译码。这与 McEliece 恰恰相反,在 McEliece 中,译码能力是被严密守护的秘密。在 HQC 中,关于 \(C\) 没有任何需要隐藏的东西:攻击者知道如何对它译码并不能获得任何优势,因为对 \(v - u\,y\) 译码首先需要计算 \(u\,y\),而这需要秘密 \(y\)。
当前的 HQC 规范对 \(C\) 使用一个级联码:外码为 Reed–Solomon 码,与内码(重复化的 Reed–Muller 码)复合而成。选择级联是出于译码性能的考虑——在良好码率下获得一个大而可靠的纠错半径——因为 \(C\) 对安全性毫无贡献。就本章而言,唯一重要的性质是接口:\(C\) 具有公开生成矩阵 \(G\)(因此 \(mG\) 是一个码字)以及一个公开译码器 \(\text{D}{\small\text{ECODE}}_C\),后者能纠正重量不超过其半径的任何错误。
23.7从 CPA 到 CCA:FO 变换#
算法 33–35 描述的是被动安全的核心:它们能抵御窃听者,但无法抵御提交选定密文并观察解封装如何响应的攻击者。与 ML-KEM 一样,HQC 借助 Fujisaki–Okamoto(FO)变换 [2] 把这一核心升级为选择密文(CCA)安全,该变换在第 16.13 节中有完整的解释。
从高层次看,FO 变换使封装对消息而言是确定性的:随机量 \(r_1, r_2, e\) 不是新鲜采样的,而是通过对 \(m\) 求哈希派生出来的。解封装随后恢复 \(m'\),用同一个 \(m'\) 重新运行封装,并检查所得密文是否与收到的密文一致。如果一致,说明该密文是诚实生成的,于是返回密钥 \(K = H(m')\);如果不一致,解封装不会发出错误信号,而是返回一个由秘密种子派生的伪随机密钥。这一“重新加密并比较”的步骤正是挫败选择密文攻击的关键,它与所有格 KEM 中使用的机制相同。上面的教学算法有意省略了这一步,以便把注意力集中在代数上。
23.8HQC 的定位#
下表把 HQC 置于其基于编码的前身与它所备份的格 KEM 之间。隐藏的是什么这一栏解释了密钥尺寸上的差异。
| Classic McEliece | HQC | ML-KEM | |
|---|---|---|---|
| 类别 | 基于编码 | 基于编码 | 基于格 |
| 隐藏的是什么 | 可译码的码 | 低重量噪声 | 低范数噪声 |
| 码 \(C\) | 秘密(经伪装) | 公开且固定 | — |
| 困难问题 | 对隐藏的 Goppa 码译码 | 对随机 QC 码译码 | 模 LWE |
| 公钥 | 大(\(\sim\) 数百 kB) | 中等(\(\sim\) 数 kB) | 小(\(<1\) kB) |
| 额外结构 | 无(无结构) | 准循环 | 模 / 环 |
23.9常见陷阱#
陷阱 1:以为码是秘密。#
在 McEliece 中,秘密是译码能力;而在 HQC 中,码 \(C\) 及其译码器是完全公开的。混淆二者会颠倒整个安全性论证。在 HQC 中,保护消息的是秘密的低重量对 \((x,y)\),没有它,人们甚至无法构造 \(u\,y\),更不用说译码了。
陷阱 2:把“低重量”理解为“小数值”。#
一切都定义在 \(\mathbb{F}_2\) 上,因此系数只有 \(0\) 或 \(1\)。这里的“小”指的是1 很少——即低 Hamming 重量——而不是小幅值。安全性差距存在于重量为 \(w\) 的向量与均匀随机向量之间,后者的重量大约为长度的一半。
陷阱 3:忘记残余错误必须在译码器能力范围之内。#
只有当 \(e' = x r_2 - y r_1 + e\) 保持在 \(C\) 的译码半径之内时,解封装才能成功。提高秘密重量 \(w, w_r, w_e\) 会加强假设,但也会增大 \(e'\);如果它超出半径,译码就会失败。这是 HQC 中与 ML-KEM 解密失败预算相对应的东西,参数经过调校以使失败概率可以忽略。
陷阱 4:以为准循环结构是免费的。#
加入准循环结构正是把密钥从 McEliece 的数百 KB 缩小到几 KB 的原因,但它也收窄了假设:HQC 依赖于对随机准循环码的译码,这是一个比对完全随机码译码更具结构性的问题。这与环 LWE 和 NTRU(第 12.15 节)中所见的效率与结构之间的取舍相同,它是一个有意识的设计选择,而不是疏忽。
陷阱 5:直接使用被动安全的核心。#
这里的教学算法只具有 CPA 安全性。一个可部署的 HQC 会用 FO 变换的“重新加密并比较”检查把它们包裹起来;跳过这一步会使方案暴露于选择密文攻击之下。
23.10小结#
HQC 隐藏噪声,而不是隐藏码。可译码的码 \(C\) 是公开且固定的;秘密是一对低重量向量 \((x,y)\)。
安全性基于准循环校验子译码。从 \((h,\,s=x+hy)\) 中恢复 \((x,y)\) 就是对一个随机准循环码译码——人们相信它在经典和量子意义下都是困难的。
其代数与 ML-KEM 相呼应。KeyGen 公布校验子 \(s\);封装构造 \(u = r_1 + h r_2\) 和 \(v = mG + s r_2 + e\);解封装抵消共享的 \(h y r_2\) 项,使得 \(v - u y = mG + e'\),其中 \(e'\) 为低重量,然后 \(C\) 的公开译码器去除 \(e'\)。
准循环结构换来了小密钥。单个环元素代表整个循环块,用几 KB 取代了 McEliece 的巨大矩阵——代价是一个更具结构性的假设,这是从 LWE 到环 LWE 那一步在编码理论中的类比。
HQC 是 NIST 基于编码的备份方案。它于 2025 年 3 月被选为额外的 KEM,以一个依赖于独立困难问题的方案补充基于格的 ML-KEM,从而使针对格的单一进展不会一次性攻破一切。一旦其 FIPS 发布,它就将成为一个获批的密钥建立方案,而 NIST 目前没有再选定更多 KEM 的计划 [3]。
评论