第 1 章量子威胁
1.1本章为何重要#
本书其余各章所构建的,都是冠以后量子之名的方案。本章解释这个词所回应的究竟是什么。后量子密码(PQC)之所以存在,是因为一台足够大的量子计算机将能攻破当今部署的几乎全部公钥密码——正是此刻保护着网络流量、软件更新和存储数据的那些算法。理解哪些问题会被攻破、哪些能够幸存,以及为什么,是后续一切内容的动机所在。
1.2学习目标#
读完本章后,你应当能够:
说出当今公钥密码所依赖的困难问题;
在较高层面上解释 Shor 算法和 Grover 算法的作用;
区分量子计算机所攻破的与它仅仅削弱的;
读懂一项量子资源估计,并说明它确立了什么、没有确立什么;
解释“先存储、后解密”,并陈述 Mosca 不等式;
将已发布的 NIST 标准和主要数学家族置于其背景之中;
解读本书中为每个参数集命名的 NIST 安全类别。
1.3当今密码的基础#
经典公钥密码建立在两个被认为对普通计算机而言困难的数论问题之上:
整数分解——给定一个大数 \(N = p\cdot q\),恢复素数 \(p\) 和 \(q\)。这是 RSA 的基础。
离散对数——在一个合适的群中给定 \(g\) 和 \(g^x\),恢复 \(x\)。这是 Diffie–Hellman 密钥交换以及 ECDSA、ECDH 等椭圆曲线方案的基础。
对经典计算机而言,求解这两个问题的已知最佳算法都需要超多项式(亚指数或更差)时间,因此可以选取参数,使攻击所需时间超过宇宙的年龄。量子计算机所消除的,恰恰就是这一安全余量。
1.4Shor 算法:攻破#
1994 年,Peter Shor 证明了量子计算机能够在多项式时间内分解整数并计算离散对数 [1]。其核心是周期查找:这两个问题都可以改写为求一个巧妙选取的函数的周期,而量子计算机借助量子傅里叶变换能高效地提取这个周期——它在所有输入的叠加态上同时对函数求值,再让结果相互干涉,使周期凸显出来。
其后果十分严峻:只要量子计算机足够大,RSA、Diffie–Hellman、ECDSA 和 ECDH 全部会被攻破,无论密钥多大。将 RSA 密钥长度加倍,对 Shor 算法而言只增加多项式量级的工作量——并不能恢复安全性。没有任何参数选择能够挽救它们。
1.5Grover 算法:削弱#
对称密码(如 AES 这样的分组密码)和哈希函数(如 SHA-3)面临的威胁较为温和。Grover 算法 [2]能加速通用搜索:在 \(N\) 种可能中找出一个被标记的元素,大约需要 \(\sqrt{N}\) 步而非 \(N\) 步。对于 \(b\) 比特的对称密钥,这会将有效安全性降低到大约 \(b/2\) 比特。
关键在于,这是二次加速,而非指数加速。因此就穷举密钥搜索而言,AES-256 仍保有大约 \(128\) 比特的通用量子搜索安全性。哈希函数的各项性质必须分别对待:对于 \(m\) 比特的理想哈希函数,原像搜索和第二原像搜索的通用 Grover 式代价约为 \(2^{m/2}\),而碰撞搜索则有不同的量子算法和代价模型。在量子查询模型中,Brassard–Høyer–Tapp 算法 [3]约以 \(2^{m/3}\) 次查询找到碰撞;存储、电路代价以及具体安全性估计需要另行分析。对称原语能够幸存,但其参数和安全目标必须审慎选择。
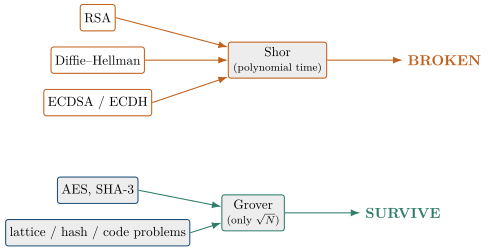
| 原语 | 量子算法 | 影响 |
|---|---|---|
| RSA | Shor | 被攻破(任意密钥长度) |
| Diffie–Hellman、ECDH | Shor | 被攻破 |
| ECDSA | Shor | 被攻破 |
| AES-128 | Grover | \(\approx 64\) 比特;应使用 AES-256 |
| SHA-256 原像 | Grover | 通用代价 \(\approx 2^{128}\) |
| SHA-256 碰撞 | 量子碰撞算法 | 需另行分析 |
| 格 / 码 / 哈希问题 | (尚无已知算法) | 幸存 |
1.6需要多大的量子计算机?#
“被一台足够大的量子计算机攻破”这一说法是正确的,但也令人不甚满意:它丝毫没有说明多大才算足够。回答这一问题的文献称为资源估计,而正确解读其结果是一项值得掌握的技能——否则本书中关于迁移的任何论证都难以令人信服。
资源估计并不是单一的数字。有三个量必须同时满足,机器只要在其中任何一项上达不到要求,就无法实施攻击:
宽度——电路同一时刻需要多少个逻辑量子比特。
深度——电路总共执行多少次逻辑操作,通常以 Toffoli 门或 \(T\) 门的数量来报告,因为这些是代价高昂的非 Clifford 操作。
挂钟时间——宽度和深度连同物理周期时间一起,决定了机器必须在纠错保护下相干地运行多长时间。一个需要十年的攻击算不上攻击。
几乎全部代价都集中在逻辑量子比特与物理量子比特之间的差距上。逻辑量子比特是由许多含噪物理量子比特构建而成的、经过纠错的抽象;目前这一开销大约为三个数量级。Google 在 2025 年证明了表面码存储器能够在阈值以下运行——增加物理量子比特会使逻辑错误率下降而非上升——正是这一结果使整个构造在原理上变得可信 [4];量子低密度奇偶校验码则是一个旨在进一步降低开销的活跃研究方向 [5]。但这两者都改变不了这样一个事实:如今已发表的逻辑量子比特数量仅为个位数或较小的两位数,而下文的估计所假设的大约是一千个。
| 目标 | 资源 | 运行时间 | 来源 |
|---|---|---|---|
| RSA-2048 | 2000 万个含噪物理量子比特 | 8 小时 | Gidney–Ekerå 2021 [6] |
| RSA-2048 | \(<1\) 百万个含噪物理量子比特 | \(<1\) 周 | Gidney 2025 [7] |
| RSA-2048 | 13,436 个量子比特 \(+\) 多模存储器 | 177 天 | Gouzien–Sangouard 2021 [8] |
| ECC-256 离散对数 | \(\approx 50\) 百万个 Toffoli 门 | — | Litinski 2023 [9] |
有两点教训比任何单独一行都更为重要。
第一点是发展方向。RSA-2048 的估计值在四年内从两千万个物理量子比特降到了不足一百万个,而这几乎完全不是来自更好的硬件:它来自更好的模运算电路和更高效的纠错。这与大多数读者原有的直觉恰恰相反。威胁的推进不仅依靠量子比特数量的增长(这代价高昂),也依靠密码学和编码理论的进步(这代价低廉)。
第二点是椭圆曲线是更容易的目标。“256 比特的密钥一定比 2048 比特的更难攻破”这种直觉在这里恰恰是错的:与安全性相当的 RSA 模数的分解相比,椭圆曲线离散对数所需的量子电路更小 [9]。任何以椭圆曲线签名的系统——也就是说几乎所有已部署的签名方案,以及第 28 章中的每一条区块链——都会先于 RSA 而非晚于 RSA 被攻破。
注 1.1 (估计确立了什么、没有确立什么). 资源估计是一种有条件的工程陈述:如果存在具有这些参数的机器,那么攻击将耗费这么多代价。它不是对这种机器何时建成的预测;一篇报告了更低数字的论文本身并没有让任何日期提前——它降低的是硬件最终必须跨越的门槛。应当把这两者视为不同的论断,并对任何将二者混为一谈的来源保持怀疑。
1.7先存储、后解密#
一个自然的反对意见是:大型量子计算机尚不存在,为何今天就要迁移?答案是先存储、后解密。敌手可以在今天记录加密流量,待若干年后量子计算机可用时再将其解密。因此,任何需要在量子计算到来之后仍保持机密的数据,现在就已经处于危险之中。
签名带来的是另一种风险。未来的量子敌手可能伪造新的签名,包括对恶意固件或证书的签名,并可能破坏长期验证。一个历史上已验证过的签名是否仍然有效,取决于其时间戳、存档证据和信任模型;这并不属于“现在记录、以后解密”的情形。这两种风险都要求在威胁成为现实之前完成迁移。
Mosca 不等式#
这一论证可以精确化。设 \(x\) 为一项秘密必须保持安全的年数(其保质期),\(y\) 为迁移本身所需的年数,\(z\) 为密码学相关量子计算机出现之前的年数。Michele Mosca 的观察 [10]是:只要下式成立,就会出现问题: \[x + y \;>\; z .\]
这一推理是一种截止期限的计算。迁移在第 \(y\) 年完成;今天创建的秘密必须存续到第 \(x\) 年;因此如果 \(x + y\) 超过 \(z\),那么在攻击者获得该能力的时刻,仍有某些秘密处于有效期内。请注意这个不等式不要求什么:任何一项都无需精确已知,尤其是 \(z\) 根本无从知晓。只要 \(x + y\) 足够大就够了,因为这样一来,在相当宽的合理 \(z\) 范围内,不等式都会被违反。
例 1.1 (问题的形态). 对于一份必须保密 50 年的医疗记录,若所在组织的迁移需要 5 年,则有 \(x + y = 55\)。没有任何严肃的估计认为 \(z\) 会接近 55 年,因此该不等式被违反,迁移已经迟了——无论关于量子时间表的争论最终如何定论。对于保质期只有几秒钟的 TLS 会话密钥,\(x + y \approx y\),计算结果完全取决于组织能以多快的速度行动。
正是这个不等式,使得第 28 章中的区块链情形比本书其余部分的情形尖锐得多:在那里,\(x\) 不是五十年,而是没有上限,因为一个提交到不可篡改账本上的公钥,只要账本存在,就一直处于暴露状态。
1.8应对之策:后量子标准#
由于 Shor 算法针对的是分解和离散对数的特定结构,防御之道便是将公钥密码建立在完全不同的困难问题之上——即那些尚无已知高效量子算法的问题。经过多年的公开竞赛,NIST 选出了首批后量子方案:
FIPS 203——ML-KEM(Kyber):密钥封装,基于模格 [11];
FIPS 204——ML-DSA(Dilithium):签名,基于模格 [12];
FIPS 205——SLH-DSA(SPHINCS+):签名,仅基于哈希函数 [13];
未来基于 Falcon 的 FN-DSA 标准另行跟踪;任何关于其实现的讨论都必须指明所遵循的草案或规范的确切版本。
后量子密码通常被归纳为五大数学家族的困难问题,每个家族都提供了通向抗量子公钥密码的一条不同路径 [14]。这是一种教学上的分类,并不意味着这些家族在密码学上相互独立。
基于格——高维格(lattice)中的短向量和含噪线性方程组 [15, 16]。它是各项标准的主力,兼顾速度与尺寸;也是本书的主要内容。
基于哈希——安全性仅归约到哈希函数;这是最保守的选择,依托于人们理解最久的假设(第 21 章)。
基于编码——对看似随机的线性码进行译码;这是最古老的家族,拥有数十年的实践记录(第 22 章)。
基于同源——沿秘密同源在椭圆曲线之间游走;密钥是所有家族中最小的,但也是最年轻、最不成熟的家族(第 25 章)。
NIST 标准是前两个家族的具体实例:三个是格方案,一个是基于哈希的方案。基于编码、多变量和基于同源的家族目前尚无 FIPS 标准,但每个家族都有活跃的候选方案,而且至关重要的是,一旦未来有攻击动摇了格,它们能提供结构上不同的对冲。表 1.3将每项标准归入其所属的家族。
| 家族 | 困难问题 | 标准 / 主要方案 | 用途 |
|---|---|---|---|
| 格 | 模 LWE | FIPS 203 ML-KEM | KEM |
| 格 | 模 LWE / SIS | FIPS 204 ML-DSA | 签名 |
| 格 | NTRU | FN-DSA / Falcon 规范 | 签名 |
| 哈希 | 原像 / 碰撞 | FIPS 205 SLH-DSA | 签名 |
| 编码 | 校验子译码 | Classic McEliece、HQC | KEM |
| 多变量 | MQ(二次方程组) | UOV、MAYO(候选) | 签名 |
| 同源 | 超奇异同源路径 | SQIsign(候选) | 签名 |
NIST 安全类别#
本书中的每个参数集都带有一个数字——ML-KEM-768、ML-DSA-65、SLH-DSA-192s——而每个数字背后都对应一个 NIST 安全类别。这些类别值得在此一次性弄清楚,因为它们解释了一种否则看起来颇为随意的约定。
NIST 面临的困难,正是第 1.6 节和上文关于 Grover 的讨论已经揭示的那个:“量子安全比特数”并不是一个定义良好的量。它取决于攻击模型、量子存储是否免费、电路深度限制,以及受到攻击的是原语的哪一项性质。NIST 没有给出一个经不起推敲的数字,而是参照一个代价已被充分理解的经典原语来定义每个类别,并要求候选方案至少与该参照一样难以攻破:
| 类别 | 至少与之一样难 | 参照攻击 | 参数集示例 |
|---|---|---|---|
| 1 | AES-128 | 穷举密钥搜索 | ML-KEM-512、SLH-DSA-128s/f |
| 2 | SHA-256 | 碰撞搜索 | ML-DSA-44 |
| 3 | AES-192 | 穷举密钥搜索 | ML-KEM-768、ML-DSA-65、SLH-DSA-192s/f |
| 4 | SHA-384 | 碰撞搜索 | (很少作为目标) |
| 5 | AES-256 | 穷举密钥搜索 | ML-KEM-1024、ML-DSA-87、SLH-DSA-256s/f |
由此得出两个推论。第一,类别在不同家族之间可以比较:一个类别 3 的格方案和一个类别 3 的基于哈希的方案作出的是相同的论断,而这恰恰是读者在本书各章之间进行选择时所需要的。第二,类别对底层假设的可信度只字未提。SLH-DSA-128s 和 ML-KEM-512 都属于类别 1,但一个依赖于哈希函数,另一个依赖于模格,而任何类别编号都无法体现这一差别。选择方案意味着既要选择类别,也要选择家族。
类别的划定是一种论断,而论断是可以被质疑的。尤其是 ML-KEM-512 被划为类别 1 一事已经引起了公开争议:其底层格攻击代价估计本身带有数十比特的公认不确定性 [18],而 NIST 为支持该划定而给出的计算也受到质疑,理由是它错误地合并了计算代价与存储访问代价 [19]。这一争议针对的是这一个参数集,而非类别体系本身;实际部署大多已统一采用 ML-KEM-768 及以上级别,从而回避了这一问题。
1.9小结#
当今的公钥密码(RSA、Diffie–Hellman、ECC)建立在分解和离散对数之上。
Shor 算法在量子计算机上以多项式时间求解这两个问题,在任意密钥长度下攻破这些方案。
Grover 算法为通用搜索带来二次加速;密钥搜索、哈希原像和哈希碰撞需要分别进行安全性分析。
资源估计同时约束宽度、深度和运行时间;RSA-2048 的已发表数字在四年内从 2000 万个物理量子比特降到了不足 100 万个,推动力来自更好的电路和纠错而非更好的硬件——而且椭圆曲线是代价更低的目标,而非更难的目标。
机密性面临“先存储、后解密”的风险;签名迁移关注的是未来的伪造和长期验证。Mosca 不等式 \(x + y > z\) 将两者都转化为一个无需知道 \(z\) 的截止期限。
本书其余部分将概览五大数学家族——格、哈希、编码、多变量和同源——其中 FIPS 203–205 是本标准快照时点已发布的 NIST 标准;每个参数集都标有一个 NIST 安全类别,该类别以 AES 密钥搜索或哈希碰撞搜索为参照来定义。
其余各章将从基础讲起:介绍有限域、向量、多项式和格等数学对象——这些新的困难问题正是建立在它们之上。
评论